In sintesi: un sito Astro multilingue è un problema strutturale prima che di traduzione. Configura cartelle di contenuto pulite per ogni locale, estrai ogni blocco traducibile in un unico CSV, chiedi a AI Glot in una sola frase di compilare ogni colonna linguistica, utilizzando la traduzione CSV di AI Glot, quindi riassembla i file programmaticamente. Una volta implementata la pipeline, l’aggiunta di una nuova lingua richiede solo l’operazione di un singolo CSV.
Questo è l’esatto workflow che utilizziamo per mantenere ai-glot.com in sei lingue (inglese, francese, tedesco, spagnolo, italiano, portoghese) senza riscrivere a mano un singolo post del blog. Lo analizzeremo dall’inizio alla fine, con i prompt che usiamo per impostare ogni passaggio con un assistente di codifica AI come Claude Code o Cursor.
L’obiettivo
Alla fine di questa guida avrai:
- Una struttura di routing i18n pulita nel tuo progetto Astro, con una cartella per lingua.
- Uno script ripetibile che estrae ogni stringa traducibile da un file markdown (o da un export di un CMS) in un singolo CSV.
- Un CSV tradotto prodotto in AI Glot, compilato in un unico passaggio per ogni colonna linguistica.
- Un secondo script che riassembla i file markdown tradotti, con percorsi delle immagini e link interni corretti per le sottodirectory localizzate.
- Un file di istruzioni che puoi consegnare al tuo assistente AI affinché ogni nuovo articolo sia, per impostazione predefinita, traducibile.
Se utilizzi già Weglot, Crowdin o un headless CMS che esporta in CSV, puoi saltare lo script di estrazione del markdown e inserire quegli export direttamente in AI Glot. La logica di traduzione e riassemblaggio è la stessa per qualsiasi progetto di traduzione di contenuti CMS.
Prerequisiti
Una breve checklist prima di iniziare.
- Un progetto Astro (v4 o v5) in esecuzione localmente, con le content collections configurate per il tuo blog.
- Node 20 o superiore, affinché le API moderne di CSV e
fs/promisesfunzionino correttamente. - Un account AI Glot (il piano gratuito è sufficiente per il primo lotto).
- Un assistente AI nel tuo editor per generare il codice boilerplate (Claude Code, Cursor, Copilot, Codeium, scegli tu).
Perché Astro è ideale per il multilingue su larga scala
Astro renderizza HTML statico per impostazione predefinita, il che significa che ogni pagina localizzata è semplicemente un file su disco. Non c’è uno strato di traduzione a runtime, nessuna ricerca nel database per il cambio lingua, nessun pacchetto JavaScript da scaricare per locale. Google indicizza ogni versione linguistica come un URL distinto con i propri meta tag, e l’output della build è essenzialmente uno specchio tradotto della tua struttura in inglese.
Questo è esattamente ciò che serve per la SEO. La SEO multilingue funziona meglio quando ogni lingua ha la propria pagina generata staticamente e scansionabile, con corrette annotazioni hreflang e una struttura URL pulita. Astro ti offre tutto questo gratuitamente.
Il compromesso: sarai tu a dover mantenere i file dei contenuti sincronizzati tra le lingue. Questo è esattamente il problema che risolve la pipeline CSV descritta di seguito.
Parte 1: Configurare la struttura di routing i18n
Astro 4 ha introdotto una configurazione i18n nativa. Il modello più pulito consiste nel dichiarare i tuoi locale, impostare il default senza prefisso (così l’inglese risiede in /blog/my-post e il francese in /fr/blog/my-post) e rispecchiare le tue content collection in una cartella [lang]/ per ogni lingua.
Ecco una struttura di riferimento per un blog in sei lingue:
src/
  content/
    blog/
      live/                          # English (default locale)
        my-first-post.md
      fr/live/                       # French
        my-first-post.md
      de/live/                       # German
        my-first-post.md
      es/live/                       # Spanish
        my-first-post.md
      it/live/                       # Italian
        my-first-post.md
      pt/live/                       # Portuguese
        my-first-post.md
  pages/
    blog/[slug].astro                # English routes
    [lang]/blog/[slug].astro         # Localized routes
  i18n/
    ui.ts                            # UI string dictionary per locale
Nota che i file markdown localizzati si trovano in una cartella più profonda rispetto a quelli in inglese. Questo livello di profondità è fondamentale: i percorsi delle immagini relativi nei markdown localizzati necessitano di un ../ extra per raggiungere src/assets/. Lo script di riassemblaggio nella Parte 4 gestisce questo aspetto automaticamente.
Se preferisci non creare questa struttura manualmente, passa il seguente prompt al tuo assistente di coding AI. È volutamente generico per funzionare con qualsiasi progetto Astro e pone le giuste domande di chiarimento prima di generare il codice.
You are helping me scaffold internationalization (i18n) in an existing Astro
project. I want to translate my entire site into multiple languages while
keeping clean URLs, proper hreflang annotations, and per-locale static pages.

Goals:
1. Declare locales in astro.config.mjs using the built-in `i18n` option.
   Default locale should NOT be prefixed (e.g. English lives at `/blog/...`,
   French at `/fr/blog/...`).
2. Create a per-locale folder structure for my content collections so each
   blog post (or CMS item) has a 1:1 file per language. The English files
   stay at their current location; localized files live one folder deeper
   (e.g. `src/content/blog/fr/live/`).
3. Add a typed UI string dictionary at `src/i18n/ui.ts` that exports an object
   keyed by locale, plus a `useTranslations(lang)` helper.
4. Update the content collection schema so the same Zod definition applies to
   every language folder.
5. Generate the dynamic route file `src/pages/[lang]/blog/[slug].astro` that
   reads from the localized content collection and falls back to English when
   a localized version is missing.
6. Add a `<LanguageSwitcher />` component that renders an anchor per locale,
   preserving the current pathname.
7. Inject `<link rel="alternate" hreflang="..." />` tags into the layout for
   every locale that has the page available.

Before you generate any code, ask me:
- The list of target locales (BCP 47 codes) and which one is the default.
- The path to my existing content collection(s) and current route files.
- Whether I want a language switcher in the header, footer, or both.
- Whether I store UI strings in JSON, TS, or somewhere else today.

Then make the changes in small, surgical commits. Do not refactor unrelated
code. Show me the diff and explain any decision where there are two valid
patterns (e.g. prefixed vs. non-prefixed default locale).
Questo approccio è intenzionale: chiarire, poi costruire. All’inizio abbiamo provato l’approccio “genera tutto subito” e ci siamo ritrovati con tre componenti diversi per il cambio lingua e uno schema di routing in conflitto con lo schema delle content collection. Chiedere all’assistente di fare domande prima di agire evita un’ora di pulizia successiva.
Parte 2: Estrarre i contenuti in un CSV per la traduzione
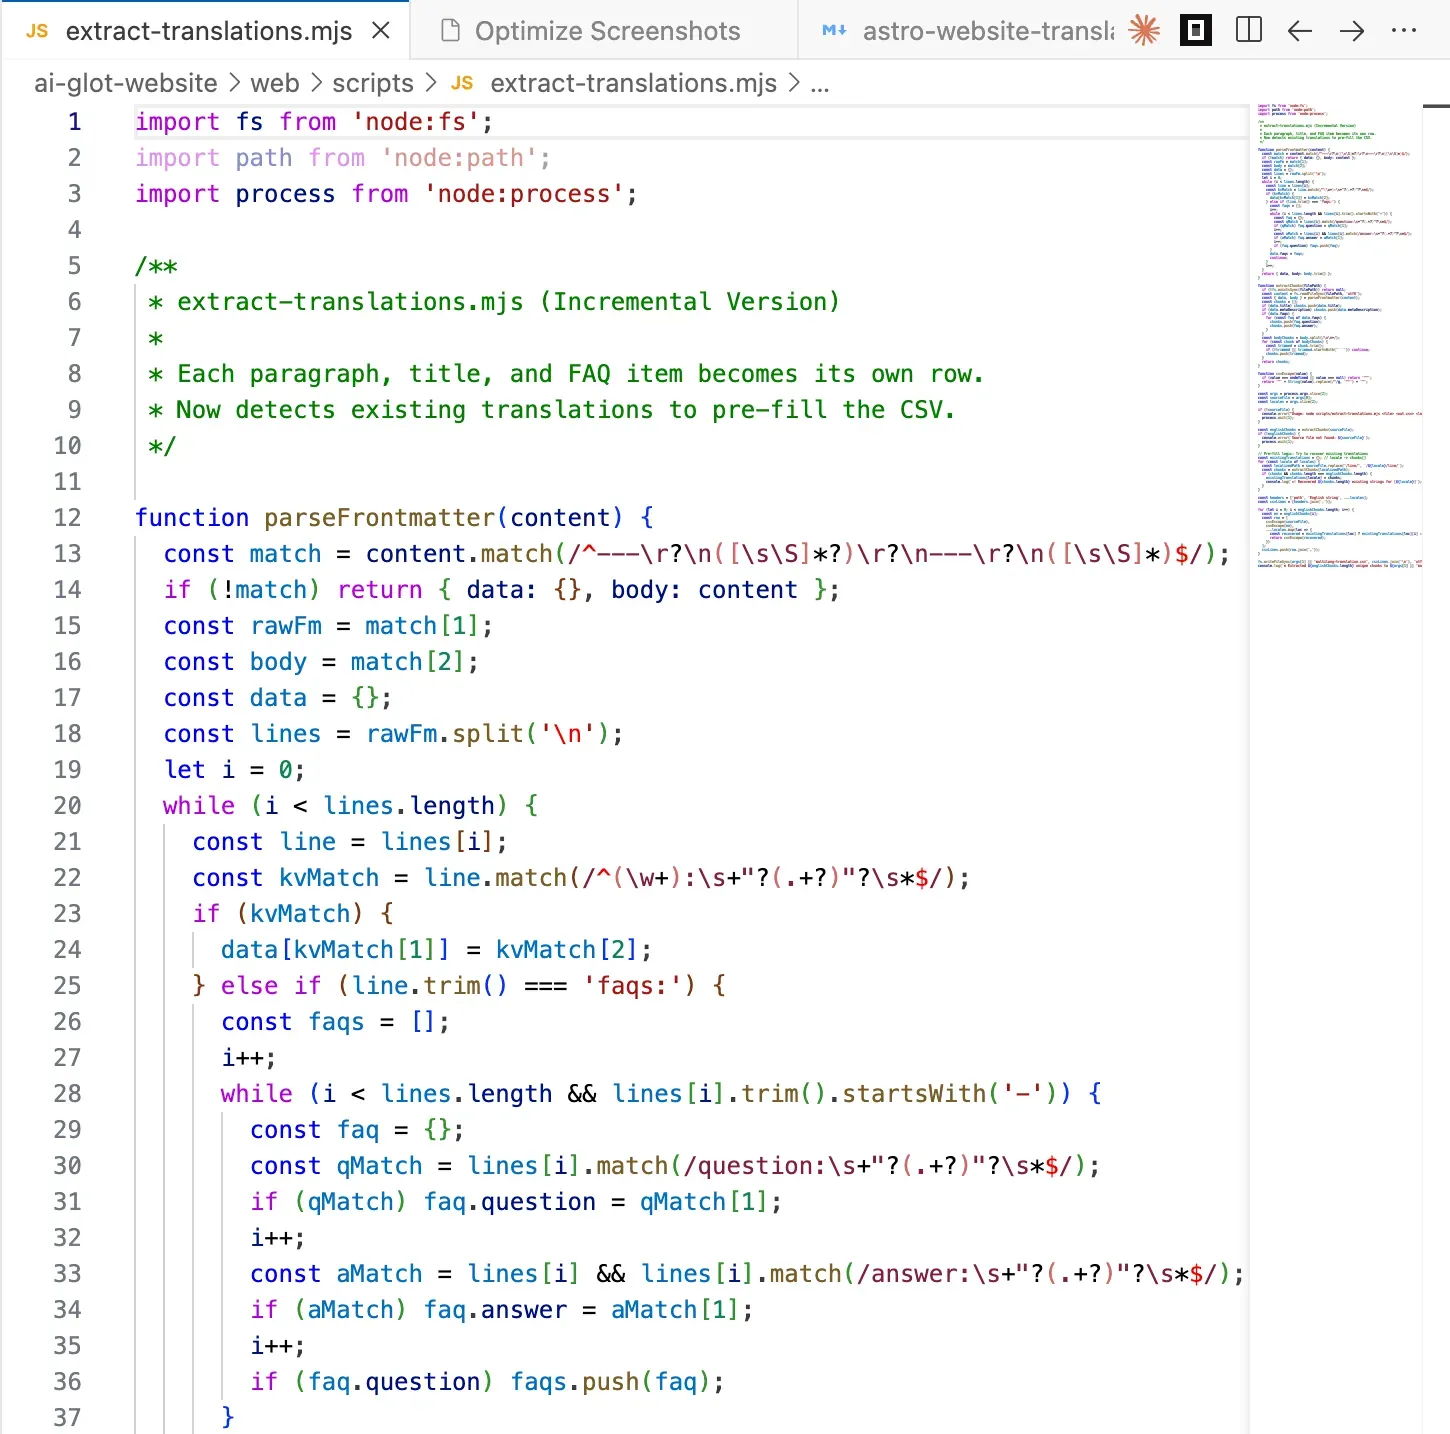
È qui che la maggior parte dei team si blocca. La traduzione in sé è la parte facile. La parte difficile è esportare i contenuti verso uno strumento di traduzione e reimportarli senza rompere la struttura.
Il trucco che rende questo processo efficace in AI Glot è l’estrazione a blocchi (chunked extraction). Dividi ogni file markdown nelle più piccole unità traducibili significative (un campo del frontmatter, una coppia di FAQ, un singolo paragrafo), scrivi ogni blocco come una riga in un CSV e aggiungi una colonna per ogni lingua di destinazione. Il risultato appare così:
| path | English string | fr | de | es | it | pt |
|---|---|---|---|---|---|---|
| live/my-first-post.md | How to translate an Astro website at scale into many languages | |||||
| live/my-first-post.md | A practical, copy-paste tutorial for shipping a multilingual Astro site. | |||||
| live/my-first-post.md | Astro renders static HTML by default, which means each localized page is just a file on disk. |
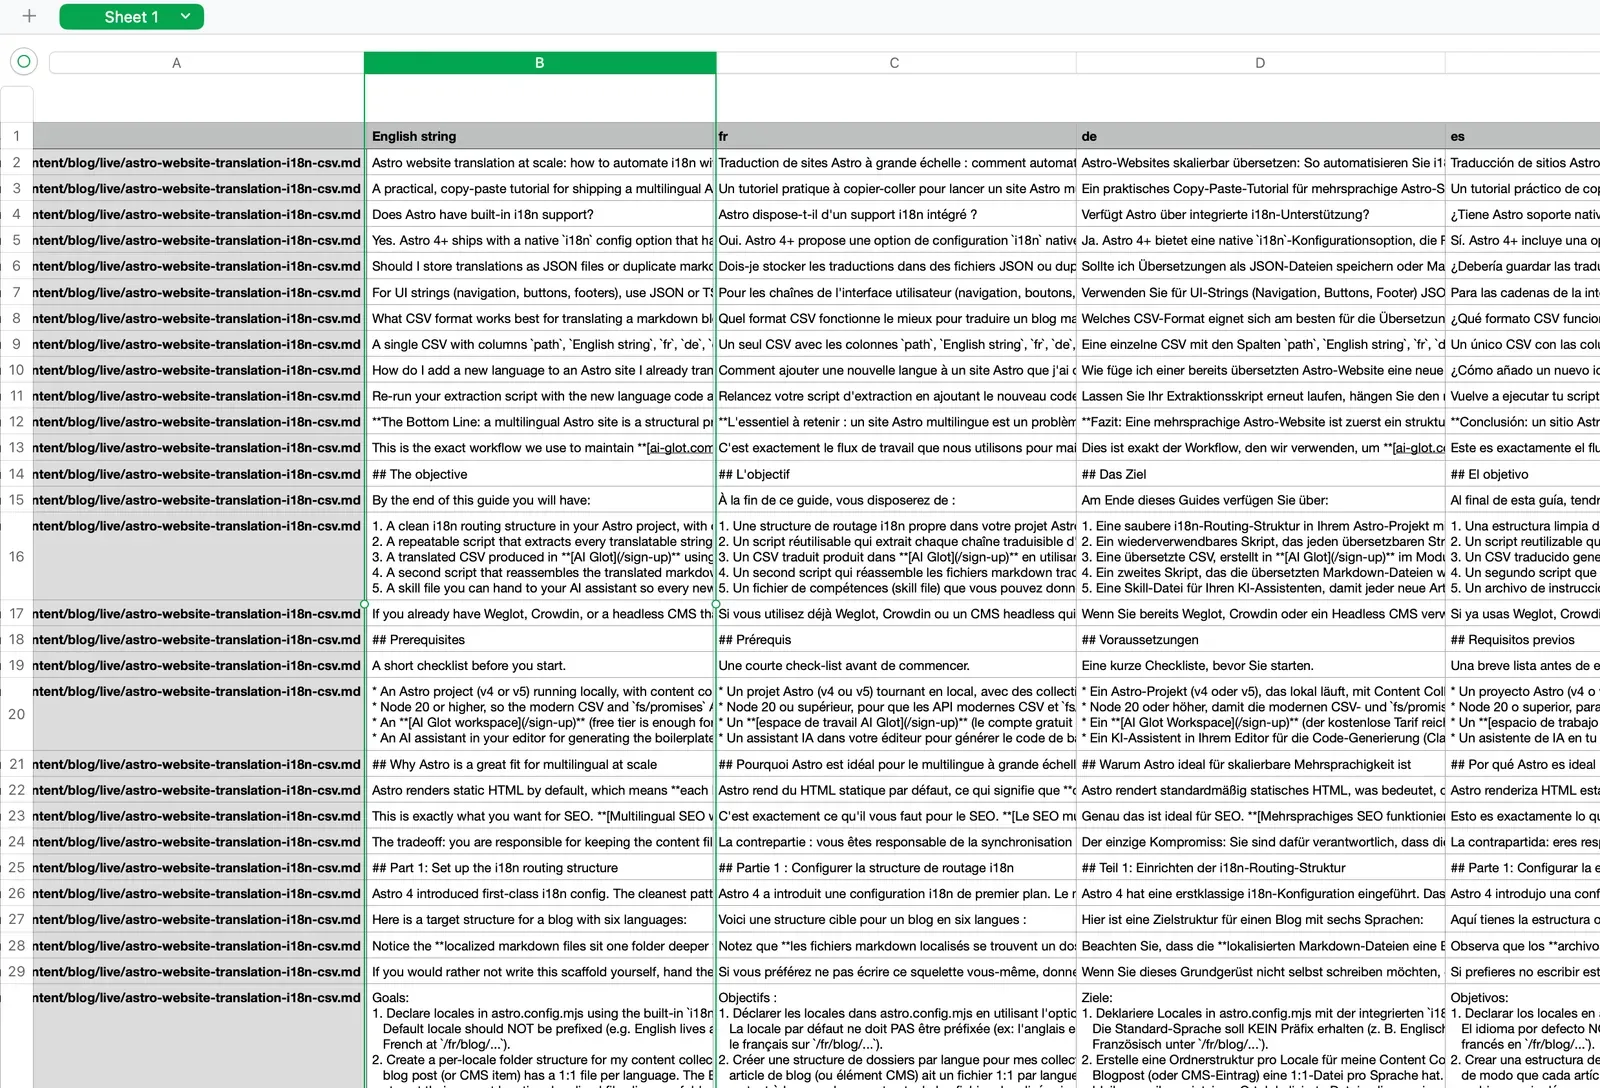
Perché a blocchi? Perché la traduzione AI funziona molto meglio su unità coerenti della dimensione di un paragrafo che su interi documenti. Le regole del glossario vengono applicate in modo coerente, il budget dei token rimane prevedibile e, se un blocco richiede una correzione, modifichi una singola cella e non un file da 2.000 parole.
Opzione A: I contenuti sono salvati come file markdown (blog, documentazione, landing page)
Usa questo prompt per generare uno script di estrazione su misura per il tuo repository. Utilizziamo una versione quasi identica per il sito web di AI Glot.
Write a Node.js script at `scripts/extract-translations.mjs` that prepares a
CSV for bulk translation in AI Glot.
Inputs:
- A source directory containing English markdown files
(e.g. `src/content/blog/live/`).
- A list of target locale codes (e.g. `fr de es it pt`).
- An output CSV path (default `multilang-translation.csv`).
For each markdown file:
1. Parse the frontmatter using `gray-matter`.
2. Extract these translatable strings, one per CSV row:
- `title` (frontmatter)
- `metaDescription` (frontmatter)
- For each entry in `faqs`: the `question` and the `answer` as separate rows.
- Each body paragraph, splitting the markdown body on `\n\n` so paragraphs,
bullet lists, blockquotes, and headings each become one row.
3. SKIP these chunks (do not include them in the CSV):
- Pure image lines starting with `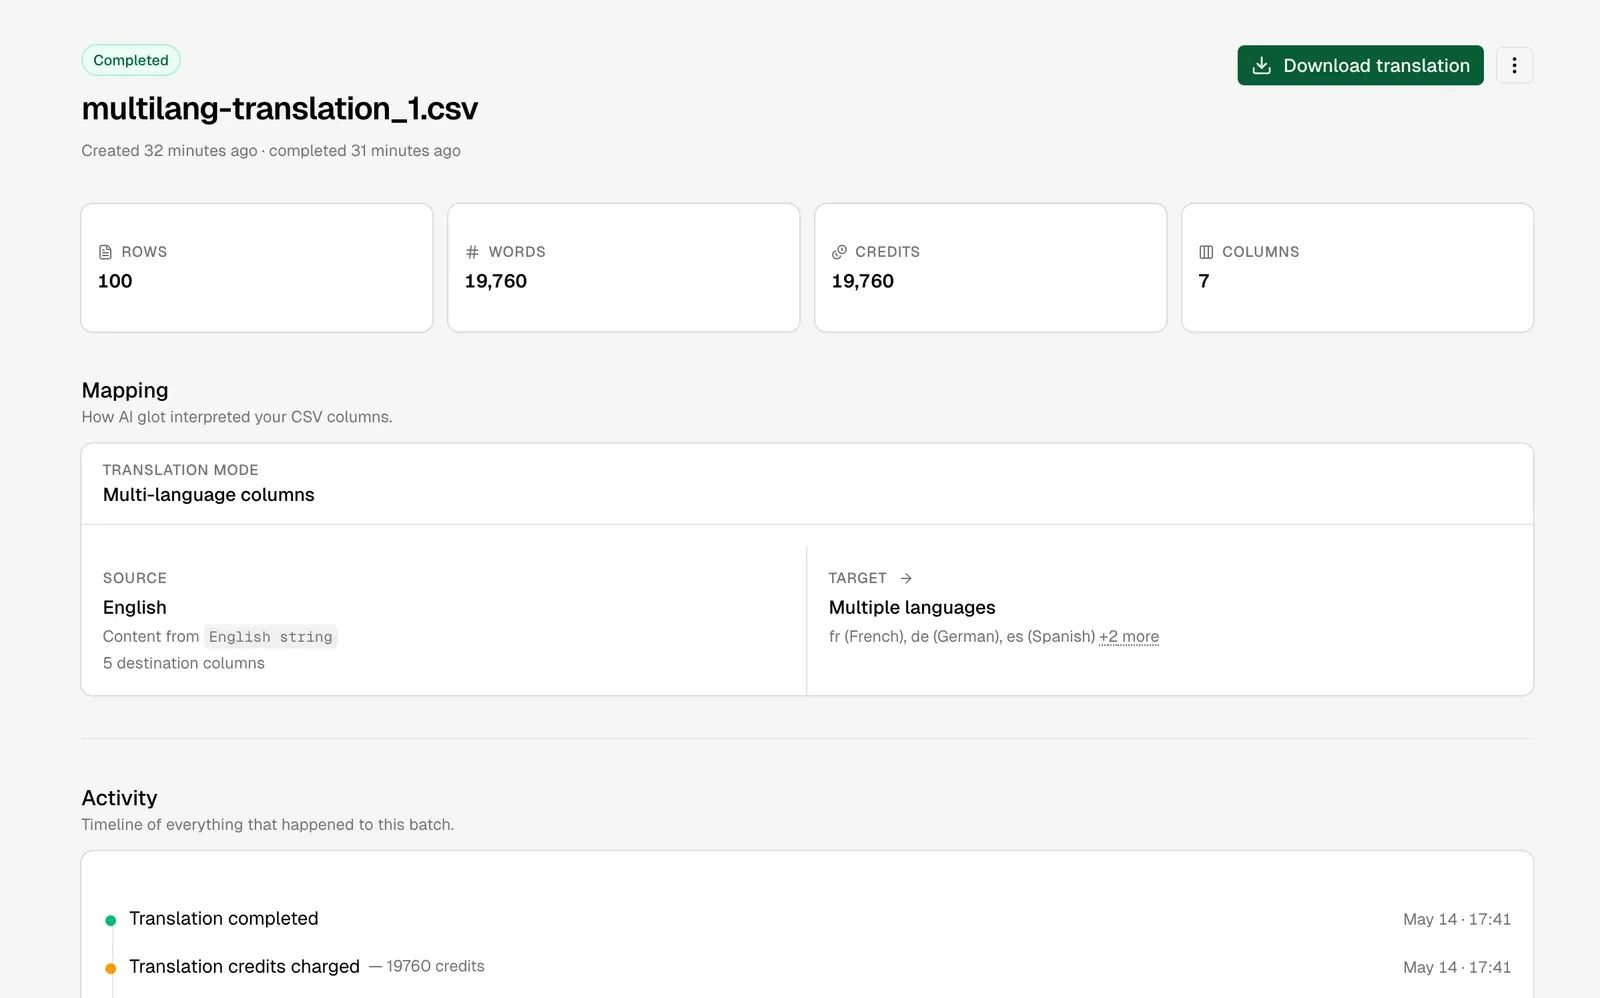
Parte 4: Reimpiegare il markdown tradotto in Astro
Ora hai un file multilang-translation_translated.csv con tutte le colonne di destinazione compilate. L’obiettivo è prendere ogni blocco tradotto e riscriverlo nel corretto file markdown localizzato, preservando esattamente la struttura originale.
Qui l’estrazione a blocchi ripaga ancora. Poiché ogni riga è associata al blocco originale in inglese, puoi semplicemente trovare e sostituire i blocchi in inglese con la loro controparte localizzata all’interno del file sorgente originale, per poi salvare il risultato nella cartella localizzata. Nessun parsing AST, nessun passaggio intermedio di markdown, nessun rischio di compromettere la formattazione.
Durante la ricostruzione devono essere apportate due correzioni strutturali:
- Percorsi delle immagini. I file in inglese fanno riferimento agli asset con
../../../assets/.... I file localizzati si trovano in una cartella più profonda, quindi il percorso relativo diventa../../../../assets/.... - Link interni. Un link come
/blog/glossary-website-translationsin inglese deve diventare/fr/blog/glossary-website-translationsin francese (e così via per ogni lingua).
Ecco il prompt che utilizziamo per generare lo script di riassemblaggio. È sufficientemente generico per essere inserito in qualsiasi progetto Astro che segua la struttura della Parte 1.
Use the unified assembly script at `scripts/assemble-blog-translations.mjs` that rebuilds
localized markdown files from an AI Glot translated CSV.

Inputs (CLI args):
- Path to the translated CSV (e.g. `multilang-translation_translated.csv`)
  with columns `path, English string, fr, de, es, it, pt`.
- The source directory containing the original English markdown files
  (default `src/content/blog/live/`).
- The destination directory pattern for localized files
  (default `src/content/blog/{lang}/live/`).
- The site origin used for internal links (default `https://ai-glot.com`).

For each unique `path` value in the CSV:
1. Read the original English file from `<sourceDir>/<path>`.
2. For each target locale column (everything after `English string`):
   a. Start from the English file's full text.
   b. For every row that matches this `path`, find the `English string`
      verbatim in the file and replace it with the value in the target
      locale column. Use literal string replace, not regex. Throw if the
      English chunk is not found (it means the source drifted from the CSV;
      this should fail loudly rather than silently skip).
   c. After all replacements, run two structural fixes on the resulting text:
      - Image paths: replace every occurrence of `../../../assets/` with
        `../../../../assets/` (one extra `../` because localized files live
        one folder deeper).
      - Internal links: replace every absolute internal URL on this site
        (e.g. `https://ai-glot.com/blog/...`) and every root-relative path
        (e.g. `/blog/...`, `/sign-up`) with the locale-prefixed equivalent
        (`/fr/blog/...`, `/fr/sign-up`). Skip anchors (`#...`), external URLs,
        and `mailto:` / `tel:` links.
   d. Write the file to `<destDir resolved with this lang>/<path>`. Create
      directories as needed.
3. After processing all paths, print a summary: files written per locale,
   total replacements, any chunks that could not be found.

Robustness:
- Use `papaparse` to read the CSV. Trim BOM if present.
- Preserve the exact frontmatter formatting (delimiters, key order, quoting).
  The simplest way is to do replacements on the raw file string, not on a
  parsed AST.
- Be idempotent: running the script twice on the same inputs produces the
  same outputs.

Make it a single self-contained file. Usage:
`node scripts/assemble-blog-translations.mjs translated.csv`
Esegui lo script e vedrai apparire una serie di nuovi file in src/content/blog/fr/live/, src/content/blog/de/live/ e così via. Controllane uno, avvia astro dev e le tue rotte localizzate dovrebbero essere renderizzate all’istante.
Bonus 1: Un file di skill per rendere ogni nuovo articolo “traducibile per impostazione predefinita”
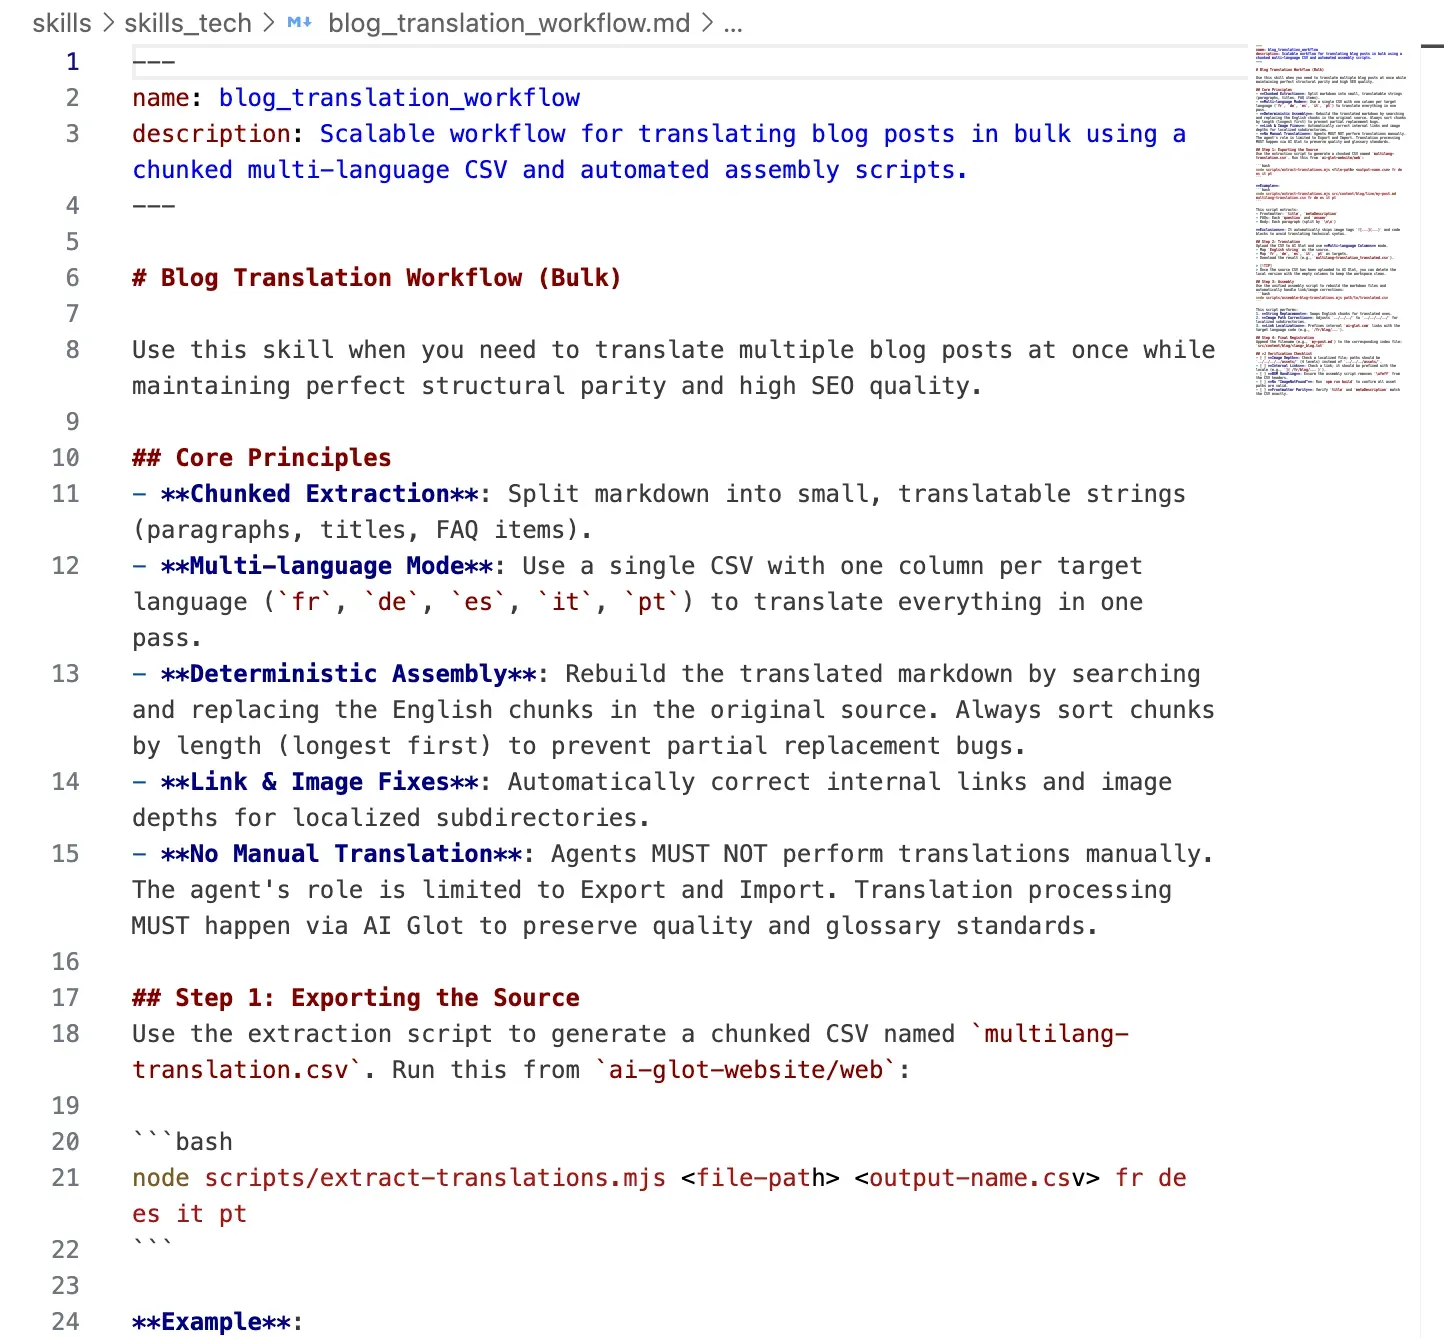
Una volta che la pipeline funziona, vorrai che ogni futuro articolo vi passi attraverso nello stesso modo. Il trucco: salva la convenzione in un file di skill che il tuo assistente AI legga prima di scrivere qualsiasi nuovo post.
Se usi Claude Code, Cursor o qualsiasi editor AI che carichi istruzioni a livello di progetto, inserisci questo file nel tuo repo come skills/blog_translation_workflow.md. In AI Glot usiamo esattamente questo modello.
---
name: blog_translation_workflow
description: How to ship a new blog post so it can be translated in bulk later.
---

# Blog translation workflow

When writing a new blog post or CMS item, follow these conventions so it
flows cleanly through the multilingual extraction pipeline.

## 1. File location and naming
- Drafts live under `src/content/blog/draft/`.
- Slug = filename = the same string used in `slug:` frontmatter.
- Move to `src/content/blog/live/` only after review.

## 2. Frontmatter contract
Every post MUST have:
- `title`: sentence case, no trailing period.
- `metaDescription`: 140 to 160 characters, full sentence.
- `coverImage`: relative path from this file's location.
- `publishedDate`: ISO date.
- `slug`: matches the filename.
- `faqs`: array of `{ question, answer }`. Minimum 3 items.

## 3. Body structure that translates well
- Use sentence-case headings (no Title Case).
- Keep paragraphs to 1 to 4 sentences. Each paragraph becomes one CSV row,
  so shorter paragraphs translate more reliably.
- Never put two images back to back; always separate them with at least one
  paragraph of explanatory text.
- Internal links use root-relative paths (`/blog/...`, `/sign-up`).
- Image paths use `../../../assets/...` (English depth).

## 4. After publishing
Run:
```bash
node scripts/extract-translations.mjs src/content/blog/live/`<slug>`.md \
  multilang-translation.csv fr de es it pt
```
to append this article's translatable chunks to the master CSV. Upload the
CSV to AI Glot and ask it to fill every language column, then run:
```bash
node scripts/assemble-blog-translations.mjs multilang-translation_translated.csv
```
to generate the localized markdown files.

## 5. Anti-patterns
- Do NOT use em-dashes; use commas or colons.
- Do NOT bold entire paragraphs. Bold key phrases only.
- Do NOT skip an FAQ section; FAQs are among the highest-value SEO blocks.
- Do NOT inline raw HTML inside markdown unless absolutely necessary;
  it complicates chunk-based reassembly.
La prossima volta che tu (o chiunque nel tuo team) scriverà un nuovo articolo, l’assistente leggerà prima questo file e produrrà un post compatibile con la pipeline senza necessità di pulizia manuale.
Bonus 2: Aggiungere una nuova lingua a tutto il blog in un unico batch
Questa è la parte che sorprende di più. Una volta creata la pipeline, aggiungere una nuova lingua è un’operazione basata su un singolo CSV per l’intero archivio del blog.
Immaginiamo di avere 80 articoli tradotti in francese, tedesco, spagnolo, italiano e portoghese, e di decidere di aggiungere l’olandese.
Il workflow:
- Riesegui lo script di estrazione aggiungendo
nlalla lista dei locale. Poiché lo script legge dalla cartella sorgente in inglese, ogni articolo (vecchio e nuovo) viene incluso. - Apri il CSV. La colonna
English stringè identica all’ultima volta. Le colonnefr, de, es, it, ptsono ancora vuote (lo script non controlla le traduzioni esistenti, crea solo la matrice vuota). La colonnanlè nuova e vuota. - Rimuovi le colonne che non devi ritradurre. Elimina
fr, de, es, it, ptdal foglio di calcolo e tienipath, English string, nl. - Carica su AI Glot e chiedi di tradurre
English stringsolo innl. - Esegui lo script di riassemblaggio con il nuovo CSV. Questo scriverà ogni articolo in
src/content/blog/nl/live/.
Sei passato da “dobbiamo aggiungere l’olandese” a “l’olandese è online” con un unico caricamento. Per 80 articoli. Ecco cosa succede quando è il workflow a lavorare, non il team.
Lo stesso modello funziona per le modifiche singole: modifica un unico paragrafo in inglese, riesporta solo i chunk interessati, traducili e ricostruisci. Gli aggiornamenti rimangono economici perché la pipeline è strutturale, non basata su documenti.
Checklist di verifica
Prima di pubblicare in produzione, effettua un controllo di coerenza per ogni locale:
npm run build(oastro build) viene completato senza erroriImageNotFound.- Passa il mouse sul selettore di lingua in un post localizzato e conferma che l’URL rimanga pulito.
- Apri un post in francese e fai un controllo a campione: titolo, meta descrizione, primi tre paragrafi, una risposta FAQ. Confrontali con l’originale.
- Clicca su un link interno all’interno del post in francese. Dovrebbe portare a un’altra pagina in francese, non tornare a quella in inglese.
- Ispeziona l’
<head>per verificare le annotazionihreflangcorrette in tutti i locale. - Esegui un audit di Lighthouse su un URL localizzato: il punteggio SEO deve essere lo stesso dell’equivalente inglese.
Se uno di questi punti fallisce, i colpevoli più comuni sono: profondità del percorso dell’immagine errata, un link interno sfuggito alla regex o un chunk che è variato tra l’estrazione e il riassemblaggio. Gli avvisi “could not find chunk” dello script di riassemblaggio ti indicano esattamente dove guardare.
Conclusione
Trattare un sito Astro multilingue come una pipeline di contenuti, piuttosto che come un progetto di traduzione occasionale, è ciò che lo rende sostenibile. Configura correttamente la pipeline (instradamento delle locale, estrazione CSV a blocchi, traduzione con AI Glot, riassemblaggio deterministico) e tradurre un nuovo articolo, correggere un paragrafo o aggiungere una nuova lingua diventerà un’operazione di routine invece di un’iniziativa trimestrale.
Gli elementi che lo rendono possibile:
- L’i18n integrato di Astro per pagine statiche pulite per ogni locale.
- Un piccolo script di estrazione che trasforma il markdown in un CSV traducibile.
- La traduzione CSV di AI Glot, a cui viene chiesto in una frase di compilare ogni colonna linguistica in un unico passaggio, con controllo del glossario e delle istruzioni.
- Uno script di riassemblaggio che gestisce la profondità delle immagini e la localizzazione dei link interni.
- Un file di skill affinché ogni nuovo articolo sia compatibile con la pipeline per impostazione predefinita.
Pronto a scalare in più lingue? Iscriviti a AI Glot, carica il tuo primo CSV di estrazione e guarda il tuo blog andare online in sei lingue entro la fine del pomeriggio.