Das Fazit: Eine mehrsprachige Astro-Seite ist in erster Linie ein strukturelles Problem, bevor es ein Übersetzungsproblem ist. Richten Sie saubere Inhaltsordner pro Sprache ein, extrahieren Sie jeden übersetzbaren Teil in eine einzige CSV, lassen Sie AI Glot mit einem einzigen Satz jede Sprachspalte ausfüllen – mithilfe der CSV-Übersetzung von AI Glot – und setzen Sie die Dateien anschließend programmatisch wieder zusammen. Sobald die Pipeline steht, ist das Hinzufügen einer neuen Sprache eine einfache CSV-Operation.
Dies ist genau der Workflow, den wir nutzen, um ai-glot.com in sechs Sprachen (Englisch, Französisch, Deutsch, Spanisch, Italienisch, Portugiesisch) zu pflegen, ohne einen einzigen Blogpost manuell neu schreiben zu müssen. Wir führen Sie Schritt für Schritt durch den Prozess, inklusive der Prompts, mit denen wir jeden Arbeitsschritt mithilfe eines KI-Coding-Assistenten wie Claude Code oder Cursor vorbereiten.
Das Ziel
Am Ende dieses Leitfadens haben Sie:
- Eine saubere i18n-Routing-Struktur in Ihrem Astro-Projekt mit einem Ordner pro Sprache.
- Ein wiederholbares Skript, das jeden übersetzbaren String aus einer Markdown-Datei (oder einem CMS-Export) in eine einzige CSV extrahiert.
- Eine in AI Glot erstellte übersetzte CSV, bei der alle Sprachspalten in einem Durchgang befüllt wurden.
- Ein zweites Skript, das die übersetzten Markdown-Dateien wieder zusammensetzt und dabei Bildpfade sowie interne Links für die lokalisierten Unterverzeichnisse korrigiert.
- Eine Skill-Datei für Ihren KI-Assistenten, damit jeder neue Artikel standardmäßig übersetzbar ist.
Wenn Sie bereits Weglot, Crowdin oder ein Headless CMS nutzen, das CSV-Exporte unterstützt, können Sie das Skript zur Markdown-Extraktion überspringen und diese Exporte direkt in AI Glot laden. Die Logik für Übersetzung und Zusammenführung ist bei jedem Projekt zur CMS-Content-Übersetzung identisch.
Voraussetzungen
Eine kurze Checkliste, bevor Sie beginnen.
- Ein lokal laufendes Astro-Projekt (v4 oder v5) mit konfigurierten Content Collections für Ihren Blog.
- Node 20 oder höher, damit die modernen CSV- und
fs/promises-APIs reibungslos funktionieren. - Ein AI Glot Konto (die kostenlose Version reicht für den ersten Durchgang aus).
- Ein KI-Assistent in Ihrem Editor zur Generierung des Boilerplates (Claude Code, Cursor, Copilot, Codeium, ganz nach Wahl).
Warum Astro ideal für mehrsprachige Seiten in großem Stil ist
Astro rendert standardmäßig statisches HTML, was bedeutet, dass jede lokalisierte Seite einfach eine Datei auf der Festplatte ist. Es gibt keine Translation-Layer zur Laufzeit, keine Datenbankabfragen für den Sprachumschalter und kein JavaScript-Bundle, das pro Sprache heruntergeladen werden muss. Google indexiert jede Sprachversion als separate URL mit eigenen Meta-Tags, und das Build-Ergebnis ist im Grunde ein überspiegelter, übersetzter Klon Ihres englischen Verzeichnisbaums.
Genau das ist ideal für SEO. Mehrsprachiges SEO funktioniert am besten, wenn jede Sprache eine eigene crawlbare, statisch generierte Seite hat, mit korrekten hreflang-Annotationen und einer sauberen URL-Struktur. Das bietet Astro kostenlos mit an Bord.
Der Kompromiss: Sie sind selbst dafür verantwortlich, dass die Inhaltsdateien über die verschiedenen Sprachen hinweg synchron bleiben. Genau dieses Problem löst die unten beschriebene CSV-Pipeline.
Teil 1: Die i18n-Routing-Struktur einrichten
Astro 4 hat eine erstklassige i18n-Konfiguration eingeführt. Das sauberste Muster besteht darin, Ihre Locales zu deklarieren, die Standardsprache auf keinen Präfix zu setzen (so liegt Englisch unter /blog/my-post und Französisch unter /fr/blog/my-post) und Ihre Content-Collections in einem [lang]/-Ordner pro Sprache zu spiegeln.
Hier ist eine Zielstruktur für einen Blog mit sechs Sprachen:
src/
  content/
    blog/
      live/                          # English (default locale)
        my-first-post.md
      fr/live/                       # French
        my-first-post.md
      de/live/                       # German
        my-first-post.md
      es/live/                       # Spanish
        my-first-post.md
      it/live/                       # Italian
        my-first-post.md
      pt/live/                       # Portuguese
        my-first-post.md
  pages/
    blog/[slug].astro                # English routes
    [lang]/blog/[slug].astro         # Localized routes
  i18n/
    ui.ts                            # UI string dictionary per locale
Beachten Sie, dass die lokalisierten Markdown-Dateien eine Ebene tiefer liegen als die englischen. Diese Tiefe ist entscheidend: Relative Bildpfade in lokalisierten Markdown-Dateien benötigen ein zusätzliches ../, um src/assets/ zu erreichen. Das Reassembly-Skript in Teil 4 erledigt dies automatisch.
Wenn Sie dieses Gerüst lieber nicht selbst erstellen möchten, geben Sie den folgenden Prompt an Ihren KI-Coding-Assistenten weiter. Er ist bewusst generisch gehalten, damit er in jedem Astro-Projekt funktioniert, und stellt die richtigen klärenden Fragen, bevor der Code generiert wird.
You are helping me scaffold internationalization (i18n) in an existing Astro
project. I want to translate my entire site into multiple languages while
keeping clean URLs, proper hreflang annotations, and per-locale static pages.

Goals:
1. Declare locales in astro.config.mjs using the built-in `i18n` option.
   Default locale should NOT be prefixed (e.g. English lives at `/blog/...`,
   French at `/fr/blog/...`).
2. Create a per-locale folder structure for my content collections so each
   blog post (or CMS item) has a 1:1 file per language. The English files
   stay at their current location; localized files live one folder deeper
   (e.g. `src/content/blog/fr/live/`).
3. Add a typed UI string dictionary at `src/i18n/ui.ts` that exports an object
   keyed by locale, plus a `useTranslations(lang)` helper.
4. Update the content collection schema so the same Zod definition applies to
   every language folder.
5. Generate the dynamic route file `src/pages/[lang]/blog/[slug].astro` that
   reads from the localized content collection and falls back to English when
   a localized version is missing.
6. Add a `<LanguageSwitcher />` component that renders an anchor per locale,
   preserving the current pathname.
7. Inject `<link rel="alternate" hreflang="..." />` tags into the layout for
   every locale that has the page available.

Before you generate any code, ask me:
- The list of target locales (BCP 47 codes) and which one is the default.
- The path to my existing content collection(s) and current route files.
- Whether I want a language switcher in the header, footer, or both.
- Whether I store UI strings in JSON, TS, or somewhere else today.

Then make the changes in small, surgical commits. Do not refactor unrelated
code. Show me the diff and explain any decision where there are two valid
patterns (e.g. prefixed vs. non-prefixed default locale).
Dieses Muster ist beabsichtigt: erst klären, dann bauen. Wir haben anfangs den Ansatz “generiere einfach alles” versucht und landeten bei drei verschiedenen Sprachumschalter-Komponenten und einem Routing-Schema, das mit unserem Content-Collection-Schema kollidierte. Wenn Sie den Assistenten bitten, zuerst nachzufragen, ersparen Sie sich später eine Stunde Aufräumarbeiten.
Teil 2: Inhalte in eine Übersetzungs-CSV exportieren
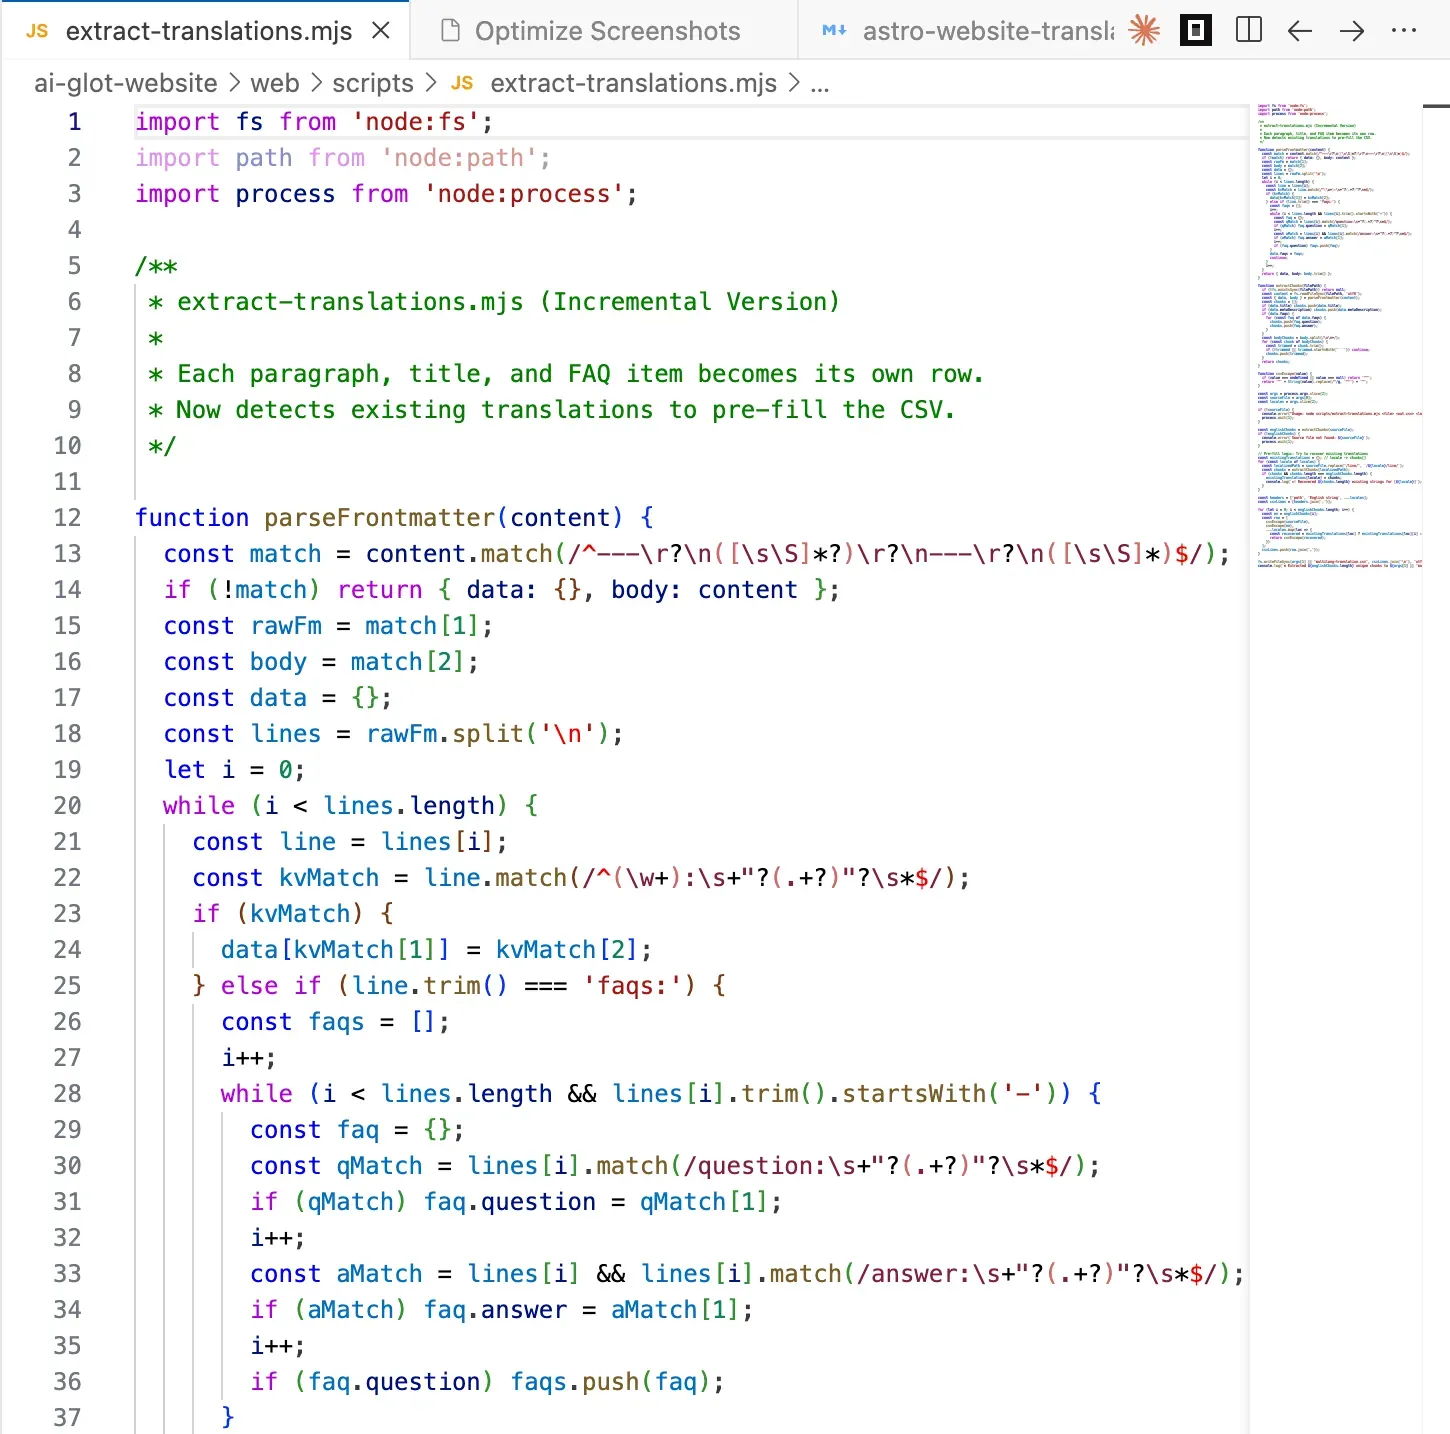
Hier bleiben die meisten Teams stecken.
Hier bleiben die meisten Teams stecken. Die Übersetzung selbst ist der einfache Teil. Der schwierige Teil ist es, die Inhalte in ein Übersetzungstool zu übertragen und wieder herauszuholen, ohne die Struktur zu beschädigen.
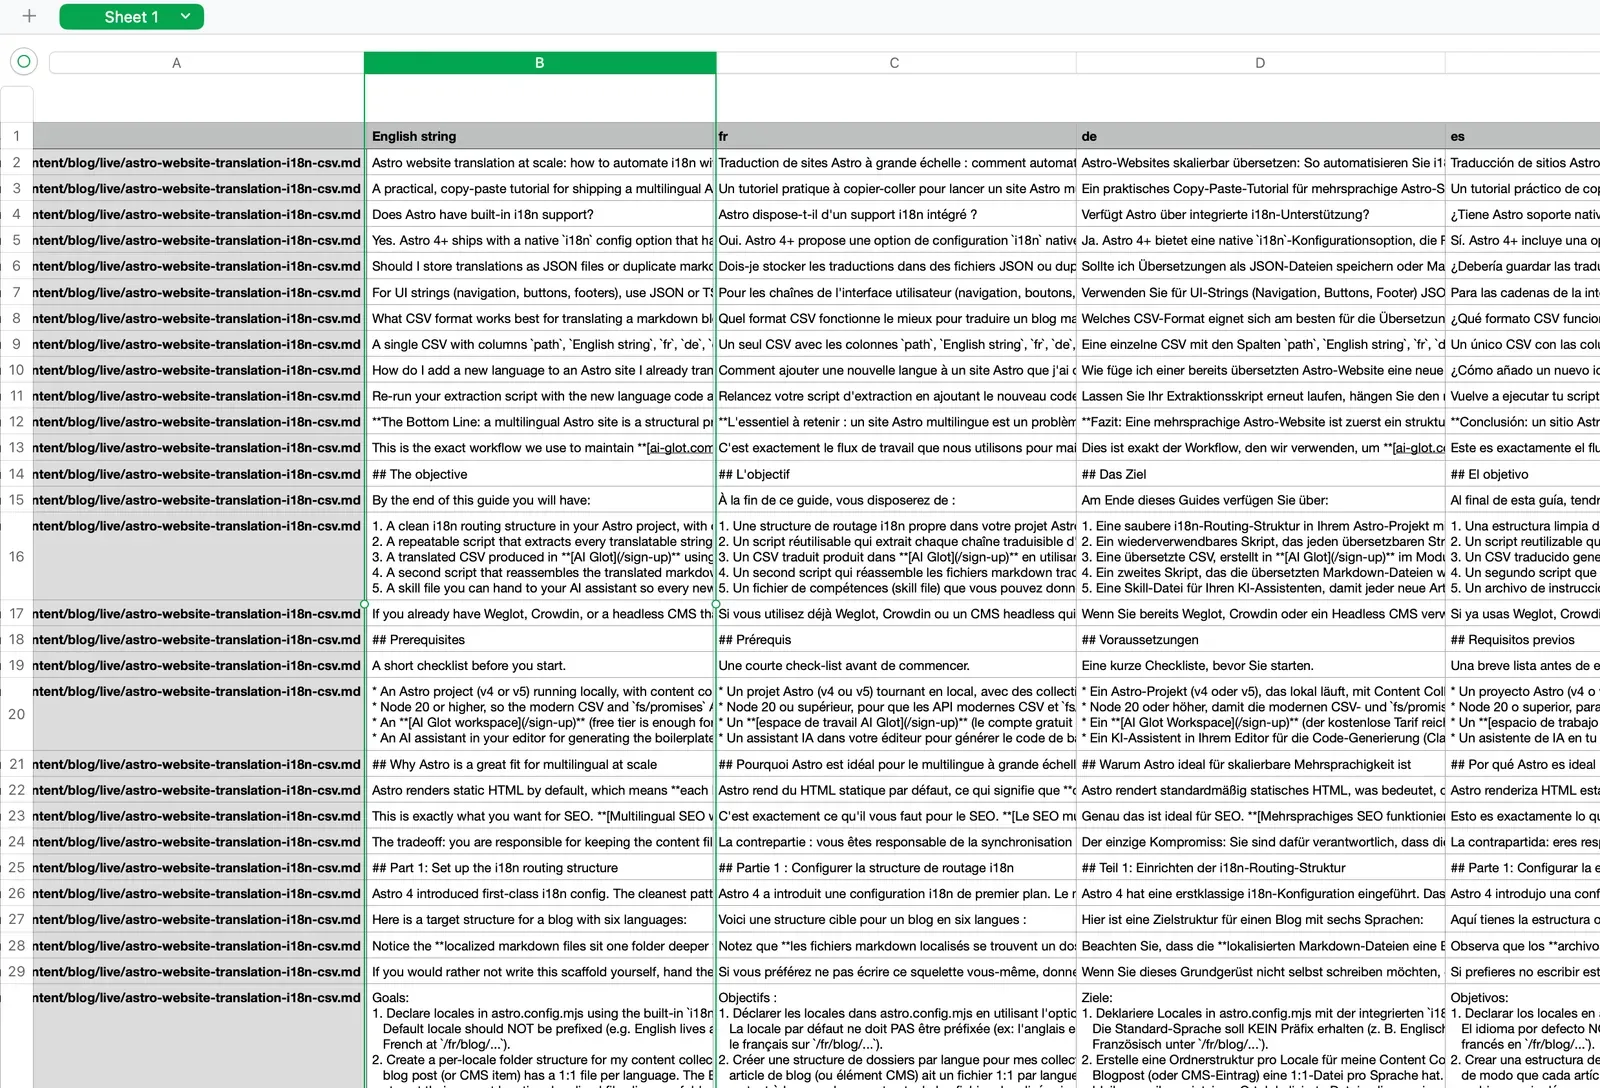
Der Trick, mit dem das in AI Glot so gut funktioniert, ist die Chunked Extraction. Dabei wird jede Markdown-Datei in die kleinstmöglichen, sinnvollen übersetzbaren Einheiten unterteilt (ein Frontmatter-Feld, ein FAQ-Paar, ein einzelner Absatz). Jeder Chunk wird als eine Zeile in einer CSV geschrieben, mit einer Spalte pro Zielsprache. Das Ergebnis sieht so aus:
| path | English string | fr | de | es | it | pt |
|---|---|---|---|---|---|---|
| live/my-first-post.md | How to translate an Astro website at scale into many languages | |||||
| live/my-first-post.md | A practical, copy-paste tutorial for shipping a multilingual Astro site. | |||||
| live/my-first-post.md | Astro renders static HTML by default, which means each localized page is just a file on disk. |
Warum in Chunks?
Warum in Chunks? Weil KI-Übersetzungen bei kohärenten Einheiten in Absatzgröße weitaus besser funktionieren als bei ganzen Dokumenten. Glossar-Regeln werden konsistent angewendet. Token-Budgets bleiben vorhersehbar. Und wenn ein Chunk korrigiert werden muss, bearbeiten Sie eine einzige Zelle und nicht eine 2.000 Wörter lange Datei.
Option A: Sie speichern Inhalte als Markdown-Dateien (Blog, Docs, Landingpages)
Nutzen Sie diesen Prompt, um ein auf Ihr Repo zugeschnittenes Export-Skript zu generieren. Wir verwenden eine fast identische Version für die AI Glot Website.
Write a Node.js script at `scripts/extract-translations.mjs` that prepares a
CSV for bulk translation in AI Glot.
Inputs:
- A source directory containing English markdown files
(e.g. `src/content/blog/live/`).
- A list of target locale codes (e.g. `fr de es it pt`).
- An output CSV path (default `multilang-translation.csv`).
For each markdown file:
1. Parse the frontmatter using `gray-matter`.
2. Extract these translatable strings, one per CSV row:
- `title` (frontmatter)
- `metaDescription` (frontmatter)
- For each entry in `faqs`: the `question` and the `answer` as separate rows.
- Each body paragraph, splitting the markdown body on `\n\n` so paragraphs,
bullet lists, blockquotes, and headings each become one row.
3. SKIP these chunks (do not include them in the CSV):
- Pure image lines starting with `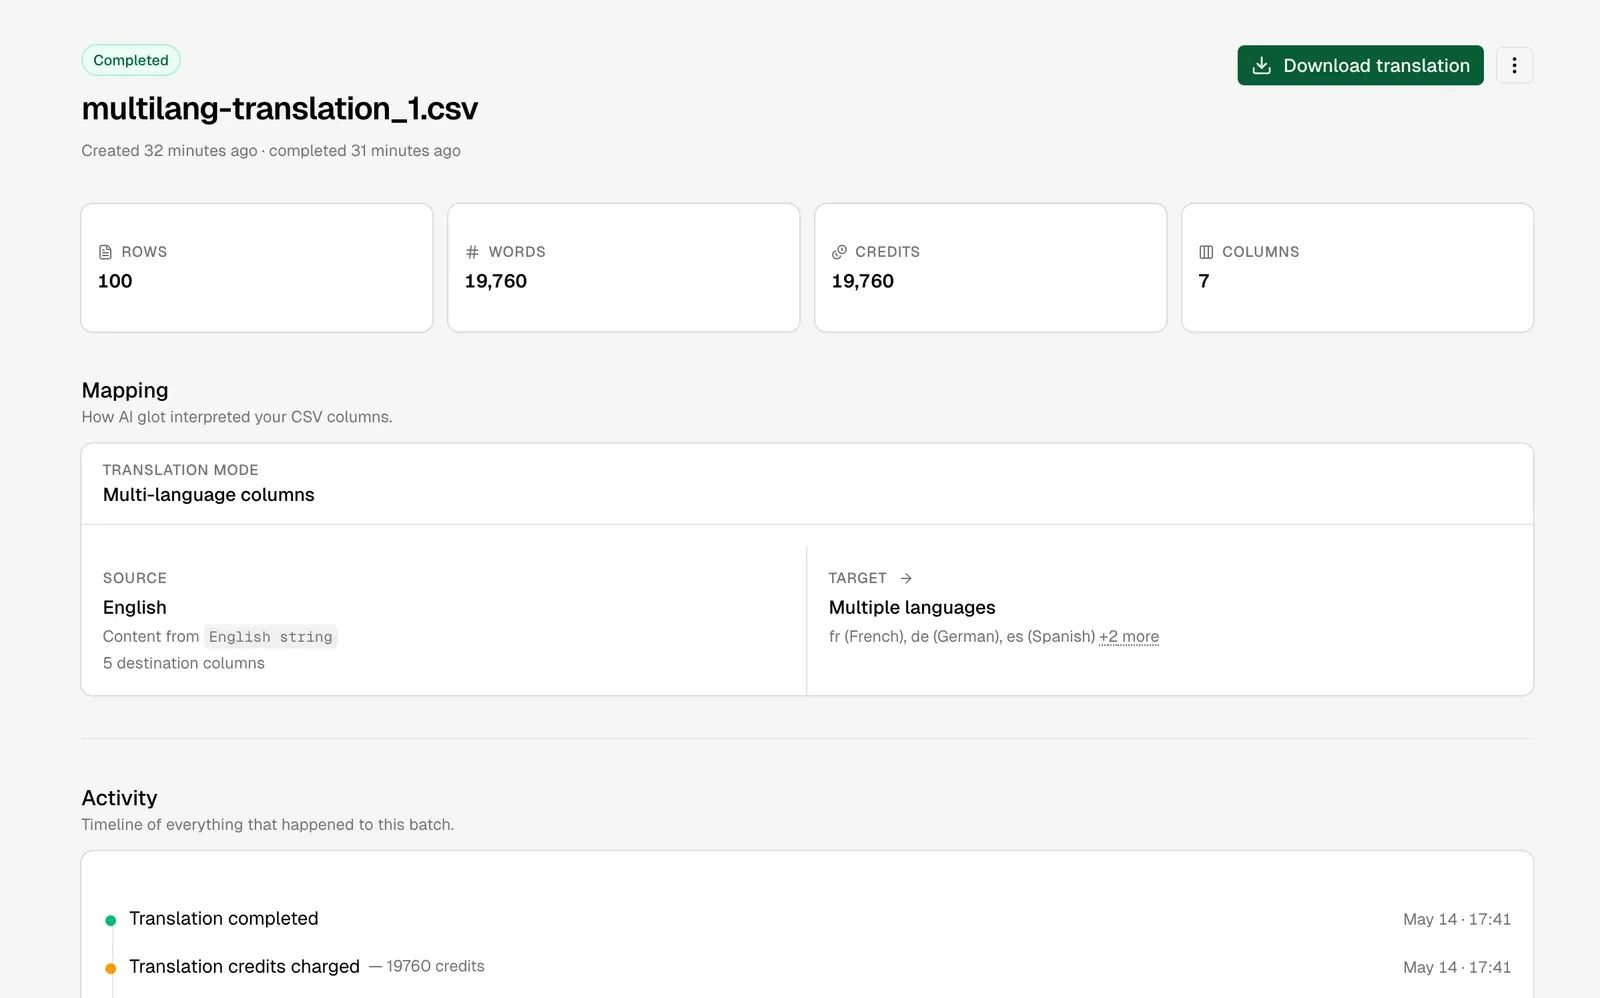
Teil 4: Übersetzten Markdown zurück in Astro zusammenführen
Nun haben Sie eine multilang-translation_translated.csv, in der jede Zielspalte gefüllt ist. Die Aufgabe besteht nun darin, jeden übersetzten Block zu nehmen und ihn zurück in die richtige lokalisierte Markdown-Datei zu schreiben, wobei die ursprüngliche Struktur exakt beibehalten wird.
Hier zahlt sich die Extraktion in Blöcken wieder aus. Da jede Zeile über den ursprünglichen englischen Block identifiziert wird, können Sie einfach die englischen Blöcke in der ursprünglichen Quelldatei durch ihr lokalisiertes Gegenstück ersetzen und das Ergebnis im lokalisierten Ordner speichern. Kein AST-Parsing, kein Markdown-Round-Tripping, kein Risiko, die Formatierung zu zerstören.
Beim Zusammenbau müssen zwei strukturelle Korrekturen vorgenommen werden:
- Bildpfade. Englische Dateien referenzieren Assets mit
../../../assets/.... Lokalisierte Dateien liegen eine Ebene tiefer, daher wird der relative Pfad zu../../../../assets/.... - Interne Links. Ein Link wie
/blog/glossary-website-translationsim Englischen muss im Französischen zu/fr/blog/glossary-website-translationswerden (und so weiter für jede Lokale).
Hier ist der Prompt, den wir verwenden, um das Zusammenführungs-Skript zu generieren. Er ist generisch genug, um in jedes Astro-Projekt eingesetzt zu werden, das der Struktur aus Teil 1 folgt.
Use the unified assembly script at `scripts/assemble-blog-translations.mjs` that rebuilds
localized markdown files from an AI Glot translated CSV.

Inputs (CLI args):
- Path to the translated CSV (e.g. `multilang-translation_translated.csv`)
  with columns `path, English string, fr, de, es, it, pt`.
- The source directory containing the original English markdown files
  (default `src/content/blog/live/`).
- The destination directory pattern for localized files
  (default `src/content/blog/{lang}/live/`).
- The site origin used for internal links (default `https://ai-glot.com`).

For each unique `path` value in the CSV:
1. Read the original English file from `<sourceDir>/<path>`.
2. For each target locale column (everything after `English string`):
   a. Start from the English file's full text.
   b. For every row that matches this `path`, find the `English string`
      verbatim in the file and replace it with the value in the target
      locale column. Use literal string replace, not regex. Throw if the
      English chunk is not found (it means the source drifted from the CSV;
      this should fail loudly rather than silently skip).
   c. After all replacements, run two structural fixes on the resulting text:
      - Image paths: replace every occurrence of `../../../assets/` with
        `../../../../assets/` (one extra `../` because localized files live
        one folder deeper).
      - Internal links: replace every absolute internal URL on this site
        (e.g. `https://ai-glot.com/blog/...`) and every root-relative path
        (e.g. `/blog/...`, `/sign-up`) with the locale-prefixed equivalent
        (`/fr/blog/...`, `/fr/sign-up`). Skip anchors (`#...`), external URLs,
        and `mailto:` / `tel:` links.
   d. Write the file to `<destDir resolved with this lang>/<path>`. Create
      directories as needed.
3. After processing all paths, print a summary: files written per locale,
   total replacements, any chunks that could not be found.

Robustness:
- Use `papaparse` to read the CSV. Trim BOM if present.
- Preserve the exact frontmatter formatting (delimiters, key order, quoting).
  The simplest way is to do replacements on the raw file string, not on a
  parsed AST.
- Be idempotent: running the script twice on the same inputs produces the
  same outputs.

Make it a single self-contained file. Usage:
`node scripts/assemble-blog-translations.mjs translated.csv`
Führen Sie das Skript aus, und Sie werden sehen, wie eine Welle neuer Dateien unter src/content/blog/fr/live/, src/content/blog/de/live/ usw. erscheint. Prüfen Sie eine Datei stichprobenartig, führen Sie astro dev aus, und Ihre lokalisierten Routen sollten sofort gerendert werden.
Bonus 1: Eine Skill-Datei, damit jeder neue Artikel “standardmäßig übersetzbar” ist
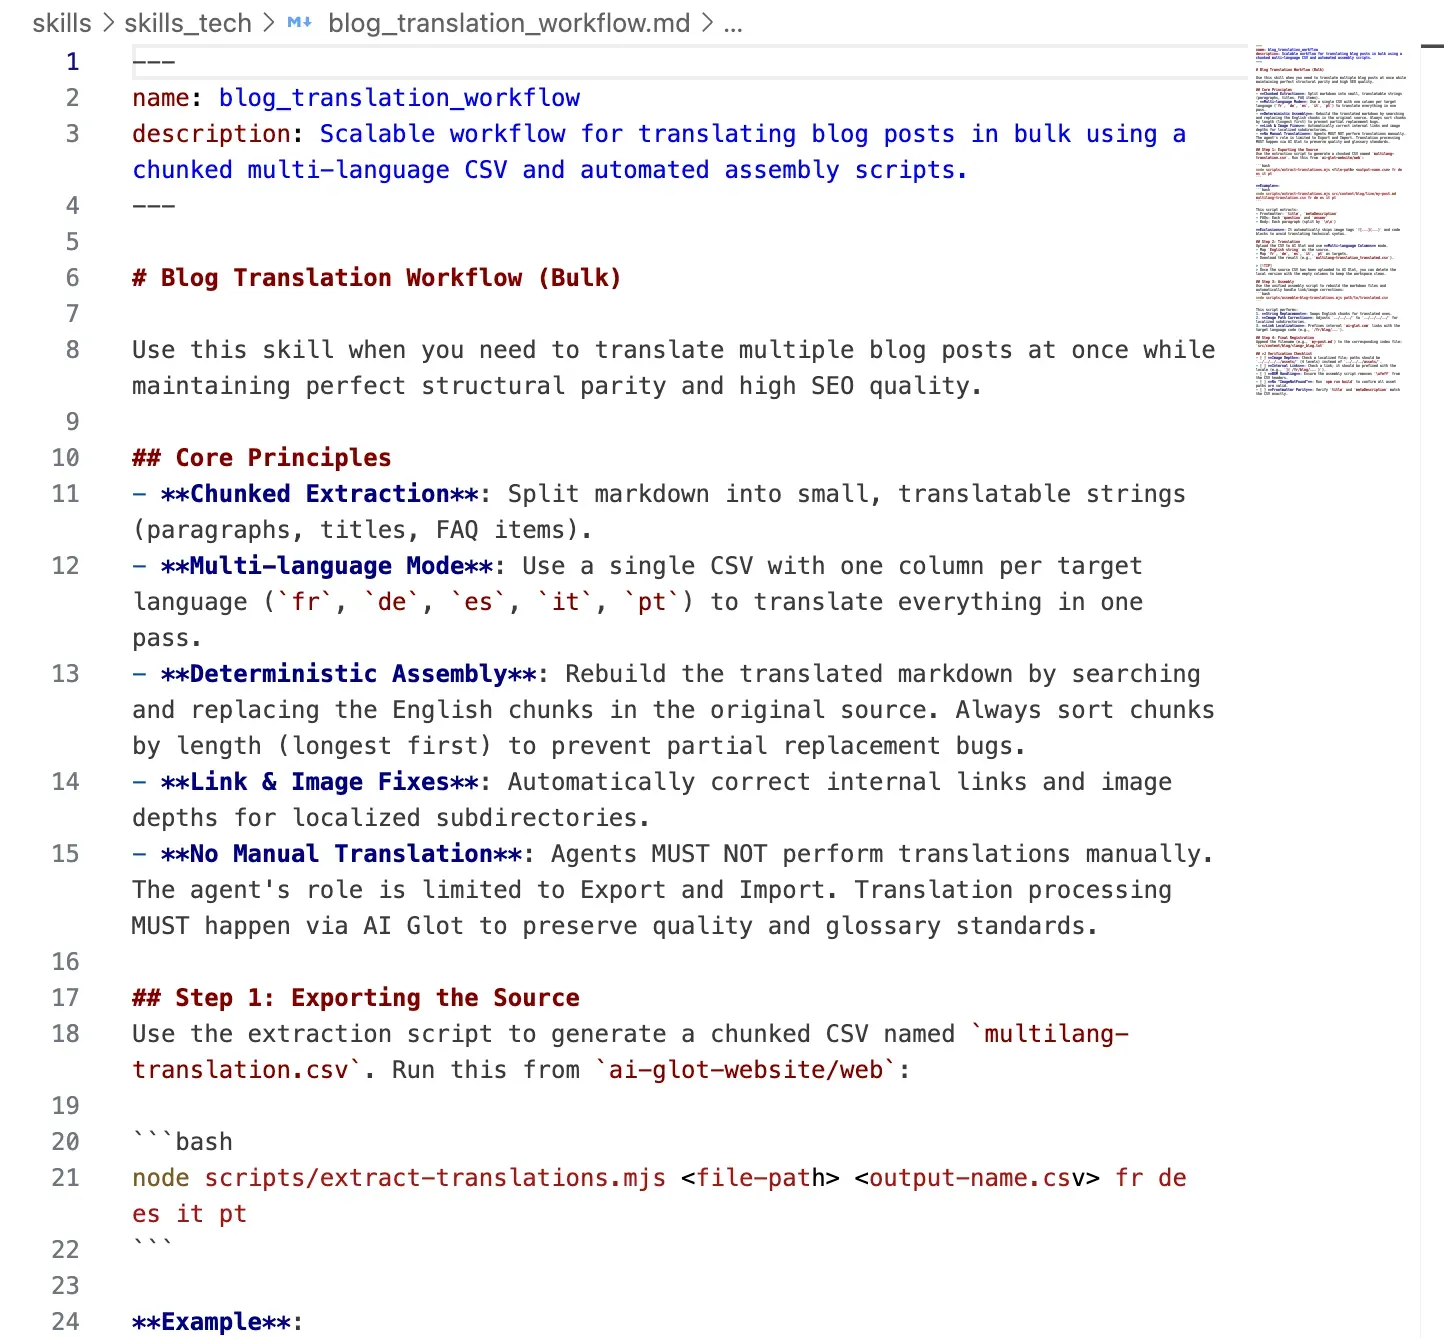
Sobald die Pipeline funktioniert, möchten Sie, dass jeder zukünftige Artikel auf die gleiche Weise durchläuft. Der Trick: Speichern Sie die Konvention als Skill-Datei, die Ihr KI-Assistent liest, bevor er einen neuen Beitrag schreibt.
Wenn Sie Claude Code, Cursor oder einen anderen KI-Editor verwenden, der Anweisungen auf Projektebene lädt, legen Sie diese Datei unter skills/blog_translation_workflow.md in Ihr Repo. Genau dieses Muster nutzen wir bei AI Glot.
---
name: blog_translation_workflow
description: How to ship a new blog post so it can be translated in bulk later.
---

# Blog translation workflow

When writing a new blog post or CMS item, follow these conventions so it
flows cleanly through the multilingual extraction pipeline.

## 1. File location and naming
- Drafts live under `src/content/blog/draft/`.
- Slug = filename = the same string used in `slug:` frontmatter.
- Move to `src/content/blog/live/` only after review.

## 2. Frontmatter contract
Every post MUST have:
- `title`: sentence case, no trailing period.
- `metaDescription`: 140 to 160 characters, full sentence.
- `coverImage`: relative path from this file's location.
- `publishedDate`: ISO date.
- `slug`: matches the filename.
- `faqs`: array of `{ question, answer }`. Minimum 3 items.

## 3. Body structure that translates well
- Use sentence-case headings (no Title Case).
- Keep paragraphs to 1 to 4 sentences. Each paragraph becomes one CSV row,
  so shorter paragraphs translate more reliably.
- Never put two images back to back; always separate them with at least one
  paragraph of explanatory text.
- Internal links use root-relative paths (`/blog/...`, `/sign-up`).
- Image paths use `../../../assets/...` (English depth).

## 4. After publishing
Run:
```bash
node scripts/extract-translations.mjs src/content/blog/live/`<slug>`.md \
  multilang-translation.csv fr de es it pt
```
to append this article's translatable chunks to the master CSV. Upload the
CSV to AI Glot and ask it to fill every language column, then run:
```bash
node scripts/assemble-blog-translations.mjs multilang-translation_translated.csv
```
to generate the localized markdown files.

## 5. Anti-patterns
- Do NOT use em-dashes; use commas or colons.
- Do NOT bold entire paragraphs. Bold key phrases only.
- Do NOT skip an FAQ section; FAQs are the highest-leverage SEO blocks.
- Do NOT inline raw HTML inside markdown unless absolutely necessary;
  it complicates chunk-based reassembly.
Wenn Sie (oder jemand aus Ihrem Team) das nächste Mal einen neuen Artikel schreiben, liest der Assistent zuerst diese Datei und erstellt einen Beitrag, der ohne manuelles Aufräumen in die Pipeline passt.
Bonus 2: Eine neue Sprache für Ihren gesamten Blog in einem einzigen Batch hinzufügen
Das ist der Teil, der die Menschen am meisten überrascht. Sobald die Pipeline existiert, ist das Hinzufügen einer neuen Sprache für Ihr gesamtes Blog-Archiv eine einfache CSV-Operation.
Angenommen, Sie haben 80 Artikel, die ins Französische, Deutsche, Spanische, Italienische und Portugiesische übersetzt wurden, und Sie entscheiden sich, Niederländisch hinzuzufügen.
Der Workflow:
- Führen Sie Ihr Extraktions-Skript erneut aus und fügen Sie
nlzur Liste der Locales hinzu. Da das Skript aus dem englischen Quellordner liest, wird jeder Artikel (alt und neu) einbezogen. - Öffnen Sie die CSV. Die Spalte
English stringist identisch mit dem letzten Mal. Die Spaltenfr, de, es, it, ptsind immer noch leer (das Skript prüft nicht auf bestehende Übersetzungen, sondern erstellt nur die leere Matrix). Die Spaltenlist neu und leer. - Kürzen Sie die Spalten, die Sie nicht erneut übersetzen müssen. Löschen Sie
fr, de, es, it, ptaus der Tabelle und behalten Siepath, English string, nl. - Laden Sie die Datei in AI Glot hoch und weisen Sie das Tool an, nur
English stringinsnlzu übersetzen. - Führen Sie das Reassembly-Skript mit der neuen CSV aus. Es schreibt jeden Artikel in
src/content/blog/nl/live/.
Sie sind in einem einzigen Upload von “wir müssen Niederländisch hinzufügen” zu “Niederländisch ist live” gelangt. Bei 80 Artikeln. Das passiert, wenn der Workflow die Arbeit erledigt und nicht das Team.
Das gleiche Muster funktioniert für einmalige Änderungen: Bearbeiten Sie einen einzelnen englischen Absatz, exportieren Sie nur die betroffenen Chunks, übersetzen Sie diese und bauen Sie alles neu auf. Updates bleiben günstig, weil die Pipeline strukturell und nicht dokumentenbasiert ist.
Verifizierungs-Checkliste
Bevor Sie in die Produktion gehen, führen Sie für jedes Locale einen Sanity-Check durch:
npm run build(oderastro build) läuft ohneImageNotFound-Fehler erfolgreich durch.- Bewegen Sie den Mauszeiger über den Sprachumschalter eines lokalisierten Beitrags und bestätigen Sie, dass die URL sauber bleibt.
- Öffnen Sie einen französischen Beitrag und prüfen Sie stichprobenartig: Titel, Meta-Beschreibung, die ersten drei Absätze, eine FAQ-Antwort. Vergleichen Sie diese mit der Quelle.
- Klicken Sie auf einen internen Link innerhalb des französischen Beitrags. Dieser sollte Sie zu einer anderen französischen Seite führen, nicht zurück ins Englische.
- Prüfen Sie den
<head>auf korrektehreflang-Annotationen über alle Locales hinweg. - Führen Sie ein Lighthouse-Audit für eine lokalisierte URL durch; der SEO-Score sollte identisch mit dem englischen Äquivalent sein.
Falls einer dieser Punkte fehlschlägt, sind die häufigsten Ursachen: falsche Bildpfad-Tiefe, ein interner Link, der den Regex entgangen ist, oder ein Chunk, der zwischen Extraktion und Reassembly verrutscht ist. Die Warnungen des Reassembly-Skripts “could not find chunk” sagen Ihnen genau, wo Sie suchen müssen.
Das Fazit
Eine mehrsprachige Astro-Seite in großem Maßstab ist kein Übersetzungsprojekt. Es ist eine Content-Pipeline. Bringen Sie die Pipeline richtig auf (Locale-Routing, Chunked-CSV-Extraktion, AI Glot Übersetzung, deterministisches Reassembly), und das Übersetzen eines neuen Artikels, das Korrigieren eines Absatzes oder das Hinzufügen einer neuen Sprache wird zu einem Routinevorgang statt zu einer Quartalsinitiative.
Die Komponenten, die es ermöglichen:
- Astros integriertes i18n für saubere statische Seiten pro Locale.
- Ein kleines Extraktions-Skript, das Markdown in eine übersetzbare CSV umwandelt.
- AI Glots CSV-Übersetzung, der mit einem Satz befohlen wird, jede Sprachspalte in einem Durchgang auszufüllen, gesteuert durch Glossar und Anweisungen.
- Ein Reassembly-Skript, das die Bildtiefe und die Lokalisierung interner Links handhabt.
- Eine Skill-Datei, damit jeder neue Artikel standardmäßig in die Pipeline passt.
Bereit für den multilingualen Versand? Melden Sie sich bei AI Glot an, laden Sie Ihre erste Extraktions-CSV hoch und erleben Sie, wie Ihr Blog bis zum Ende des Nachmittags in sechs Sprachen online geht.