L’essentiel : un site Astro multilingue est un problème structurel avant d’être un problème de traduction. Créez des dossiers de contenu propres par locale, extrayez chaque bloc traduisible dans un seul CSV, demandez à AI Glot en une phrase de remplir chaque colonne de langue via la traduction CSV d’AI Glot, puis réassemblez les fichiers par programmation. Une fois le pipeline en place, l’ajout d’une nouvelle langue se résume à une opération sur un seul CSV.
C’est exactement le flux de travail que nous utilisons pour maintenir ai-glot.com en six langues (anglais, français, allemand, espagnol, italien, portugais) sans réécrire un seul article de blog à la main. Nous allons vous guider de bout en bout, avec les prompts que nous utilisons pour structurer chaque étape avec un assistant de code IA tel que Claude Code ou Cursor.
L’objectif
À la fin de ce guide, vous disposerez de :
- Une structure de routage i18n propre dans votre projet Astro, avec un dossier par langue.
- Un script répétable qui extrait chaque chaîne traduisible d’un fichier markdown (ou d’un export CMS) vers un seul CSV.
- Un CSV traduit produit dans AI Glot, rempli en une seule passe pour toutes les colonnes de langue.
- Un second script qui réassemble les fichiers markdown traduits, avec les chemins d’images et les liens internes corrigés pour les sous-répertoires localisés.
- Un fichier de compétences à remettre à votre assistant IA pour que chaque nouvel article soit traduisible par défaut.
Si vous utilisez déjà Weglot, Crowdin ou un CMS headless qui exporte en CSV, vous pouvez ignorer le script d’extraction markdown et injecter ces exports directement dans AI Glot. La logique de traduction et de réassemblage est la même pour tout projet de traduction de contenu CMS.
Prérequis
Une courte liste de vérification avant de commencer.
- Un projet Astro (v4 ou v5) tournant localement, avec des collections de contenu configurées pour votre blog.
- Node 20 ou supérieur, pour que les API CSV modernes et
fs/promisesfonctionnent correctement. - Un compte AI Glot (l’offre gratuite suffit pour le premier lot).
- Un assistant IA dans votre éditeur pour générer le code de base (Claude Code, Cursor, Copilot, Codeium, au choix).
Pourquoi Astro est idéal pour le multilingue à grande échelle
Astro génère du HTML statique par défaut, ce qui signifie que chaque page localisée n’est qu’un fichier sur le disque. Il n’y a pas de couche de traduction au moment de l’exécution, pas de recherche dans une base de données pour le sélecteur de langue, ni de bundle JavaScript à télécharger par locale. Google indexe chaque version linguistique comme une URL distincte avec ses propres balises meta, et le résultat du build est essentiellement un miroir traduit de votre arborescence anglaise.
C’est exactement ce dont vous avez besoin pour le SEO. Le SEO multilingue fonctionne mieux lorsque chaque langue possède sa propre page statique et explorable, avec des annotations hreflang appropriées et une structure d’URL propre. Astro vous offre cela gratuitement.
Le compromis : vous êtes responsable de la synchronisation des fichiers de contenu entre les langues. C’est précisément le problème que résout le pipeline CSV ci-dessous.
Partie 1 : Configurer la structure du routage i18n
Astro 4 a introduit une configuration i18n native. Le modèle le plus propre consiste à déclarer vos locales, à définir le défaut sans préfixe (ainsi, l’anglais se trouve à /blog/my-post et le français à /fr/blog/my-post), et à refléter vos collections de contenu dans un dossier [lang]/ par langue.
Voici une structure cible pour un blog en six langues :
src/
  content/
    blog/
      live/                          # English (default locale)
        my-first-post.md
      fr/live/                       # French
        my-first-post.md
      de/live/                       # German
        my-first-post.md
      es/live/                       # Spanish
        my-first-post.md
      it/live/                       # Italian
        my-first-post.md
      pt/live/                       # Portuguese
        my-first-post.md
  pages/
    blog/[slug].astro                # English routes
    [lang]/blog/[slug].astro         # Localized routes
  i18n/
    ui.ts                            # UI string dictionary per locale
Remarquez que les fichiers markdown localisés se trouvent un niveau de dossier plus bas que les fichiers anglais. Cette profondeur est importante : les chemins d’image relatifs dans le markdown localisé nécessitent un ../ supplémentaire pour atteindre src/assets/. Le script de réassemblage de la Partie 4 gère cela automatiquement.
Si vous préférez ne pas créer cet échafaudage vous-même, donnez le prompt suivant à votre assistant de codage IA. Il est intentionnellement générique pour fonctionner sur n’importe quel projet Astro, et il pose les questions de clarification nécessaires avant de générer le code.
You are helping me scaffold internationalization (i18n) in an existing Astro
project. I want to translate my entire site into multiple languages while
keeping clean URLs, proper hreflang annotations, and per-locale static pages.

Goals:
1. Declare locales in astro.config.mjs using the built-in `i18n` option.
   Default locale should NOT be prefixed (e.g. English lives at `/blog/...`,
   French at `/fr/blog/...`).
2. Create a per-locale folder structure for my content collections so each
   blog post (or CMS item) has a 1:1 file per language. The English files
   stay at their current location; localized files live one folder deeper
   (e.g. `src/content/blog/fr/live/`).
3. Add a typed UI string dictionary at `src/i18n/ui.ts` that exports an object
   keyed by locale, plus a `useTranslations(lang)` helper.
4. Update the content collection schema so the same Zod definition applies to
   every language folder.
5. Generate the dynamic route file `src/pages/[lang]/blog/[slug].astro` that
   reads from the localized content collection and falls back to English when
   a localized version is missing.
6. Add a `<LanguageSwitcher />` component that renders an anchor per locale,
   preserving the current pathname.
7. Inject `<link rel="alternate" hreflang="..." />` tags into the layout for
   every locale that has the page available.

Before you generate any code, ask me:
- The list of target locales (BCP 47 codes) and which one is the default.
- The path to my existing content collection(s) and current route files.
- Whether I want a language switcher in the header, footer, or both.
- Whether I store UI strings in JSON, TS, or somewhere else today.

Then make the changes in small, surgical commits. Do not refactor unrelated
code. Show me the diff and explain any decision where there are two valid
patterns (e.g. prefixed vs. non-prefixed default locale).
Ce modèle est intentionnel : clarifier, puis construire. Nous avons essayé l’approche « génère tout d’un coup » au début et nous nous sommes retrouvés avec trois composants de changement de langue différents et un schéma de routage en conflit avec notre schéma de collection de contenu. Demander à l’assistant de vous interroger d’abord permet d’économiser une heure de nettoyage par la suite.
Partie 2 : Extraire votre contenu dans un CSV de traduction
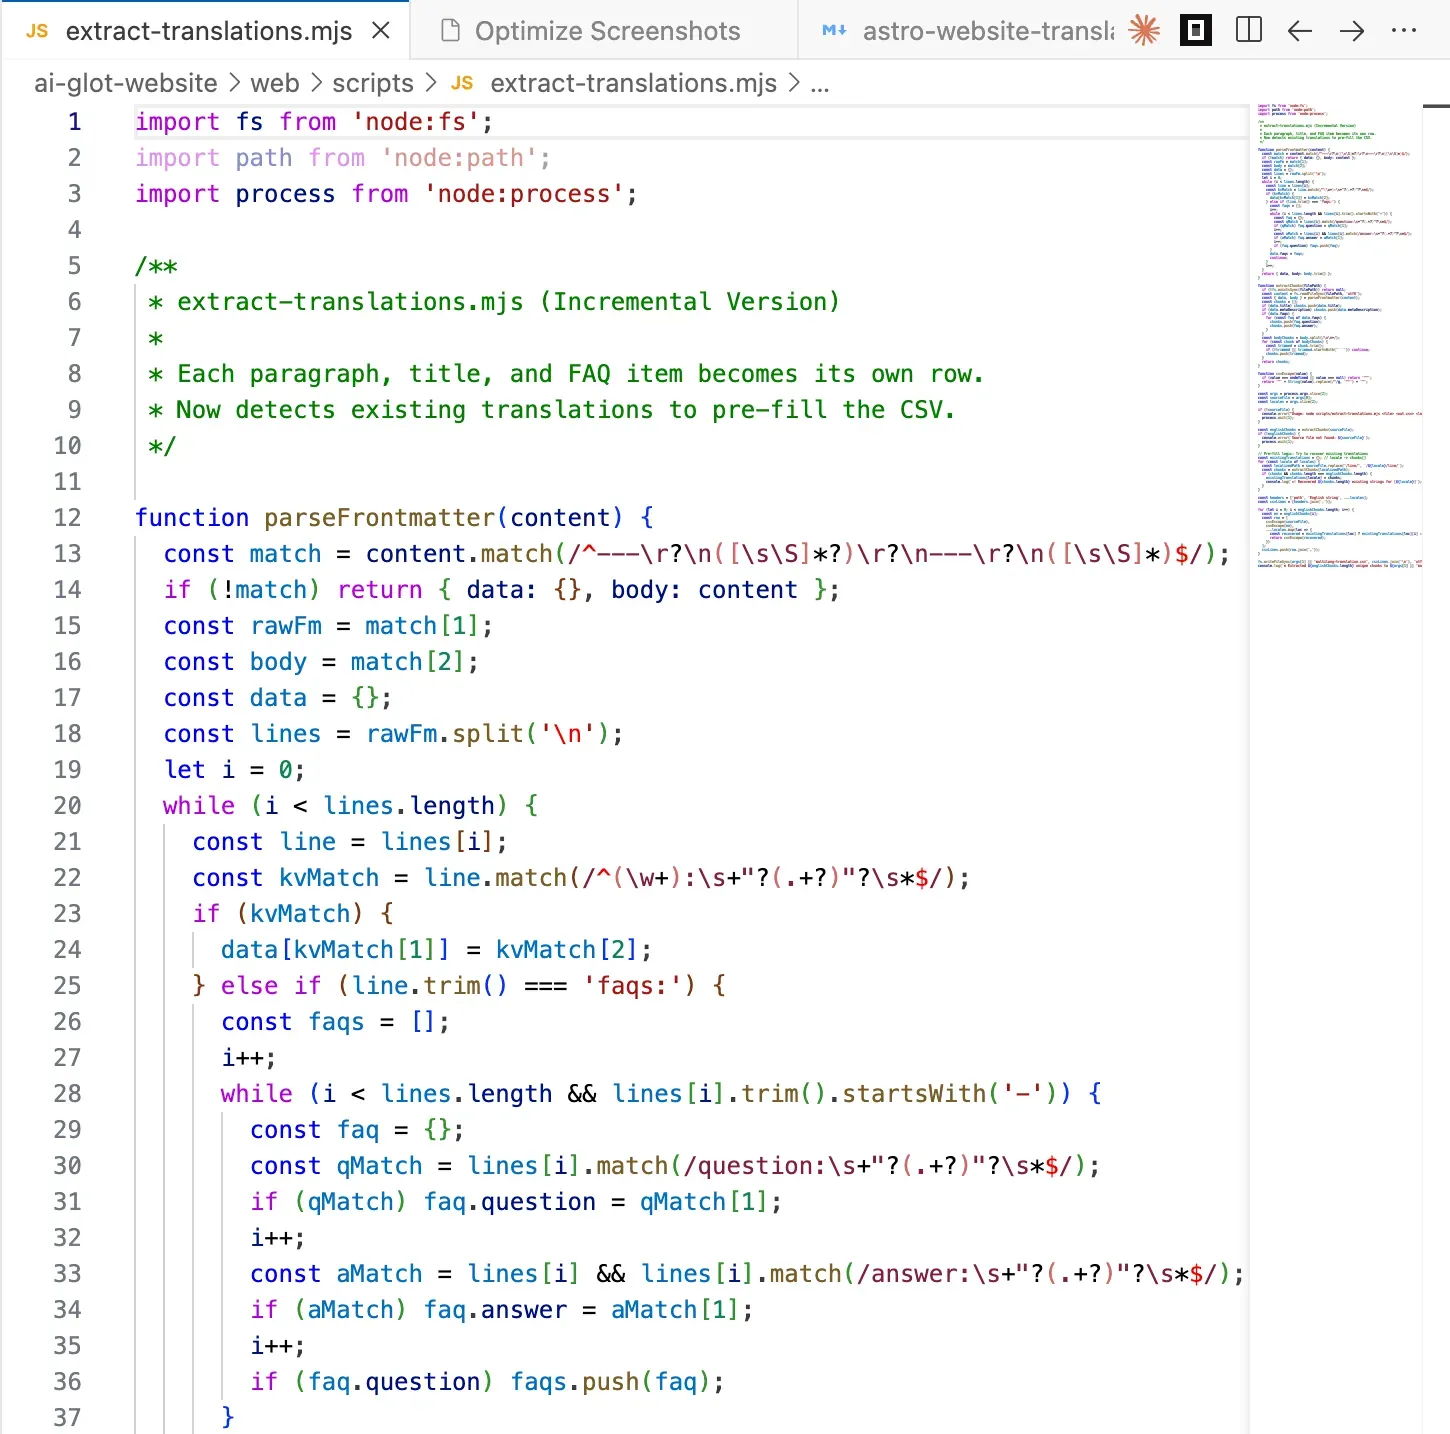
C’est là que la plupart des équipes bloquent. La traduction elle-même est la partie facile. Le plus difficile est d’importer et d’exporter votre contenu d’un outil de traduction sans briser la structure.
L’astuce qui rend cela efficace dans AI Glot est l’extraction segmentée. Vous divisez chaque fichier markdown en unités traduisibles minimales et cohérentes (un champ frontmatter, une paire FAQ, un seul paragraphe), vous écrivez chaque segment sur une ligne d’un CSV, et vous ajoutez une colonne par langue cible. Le résultat ressemble à ceci :
| path | English string | fr | de | es | it | pt |
|---|---|---|---|---|---|---|
| live/my-first-post.md | How to translate an Astro website at scale into many languages | |||||
| live/my-first-post.md | A practical, copy-paste tutorial for shipping a multilingual Astro site. | |||||
| live/my-first-post.md | Astro renders static HTML by default, which means each localized page is just a file on disk. |
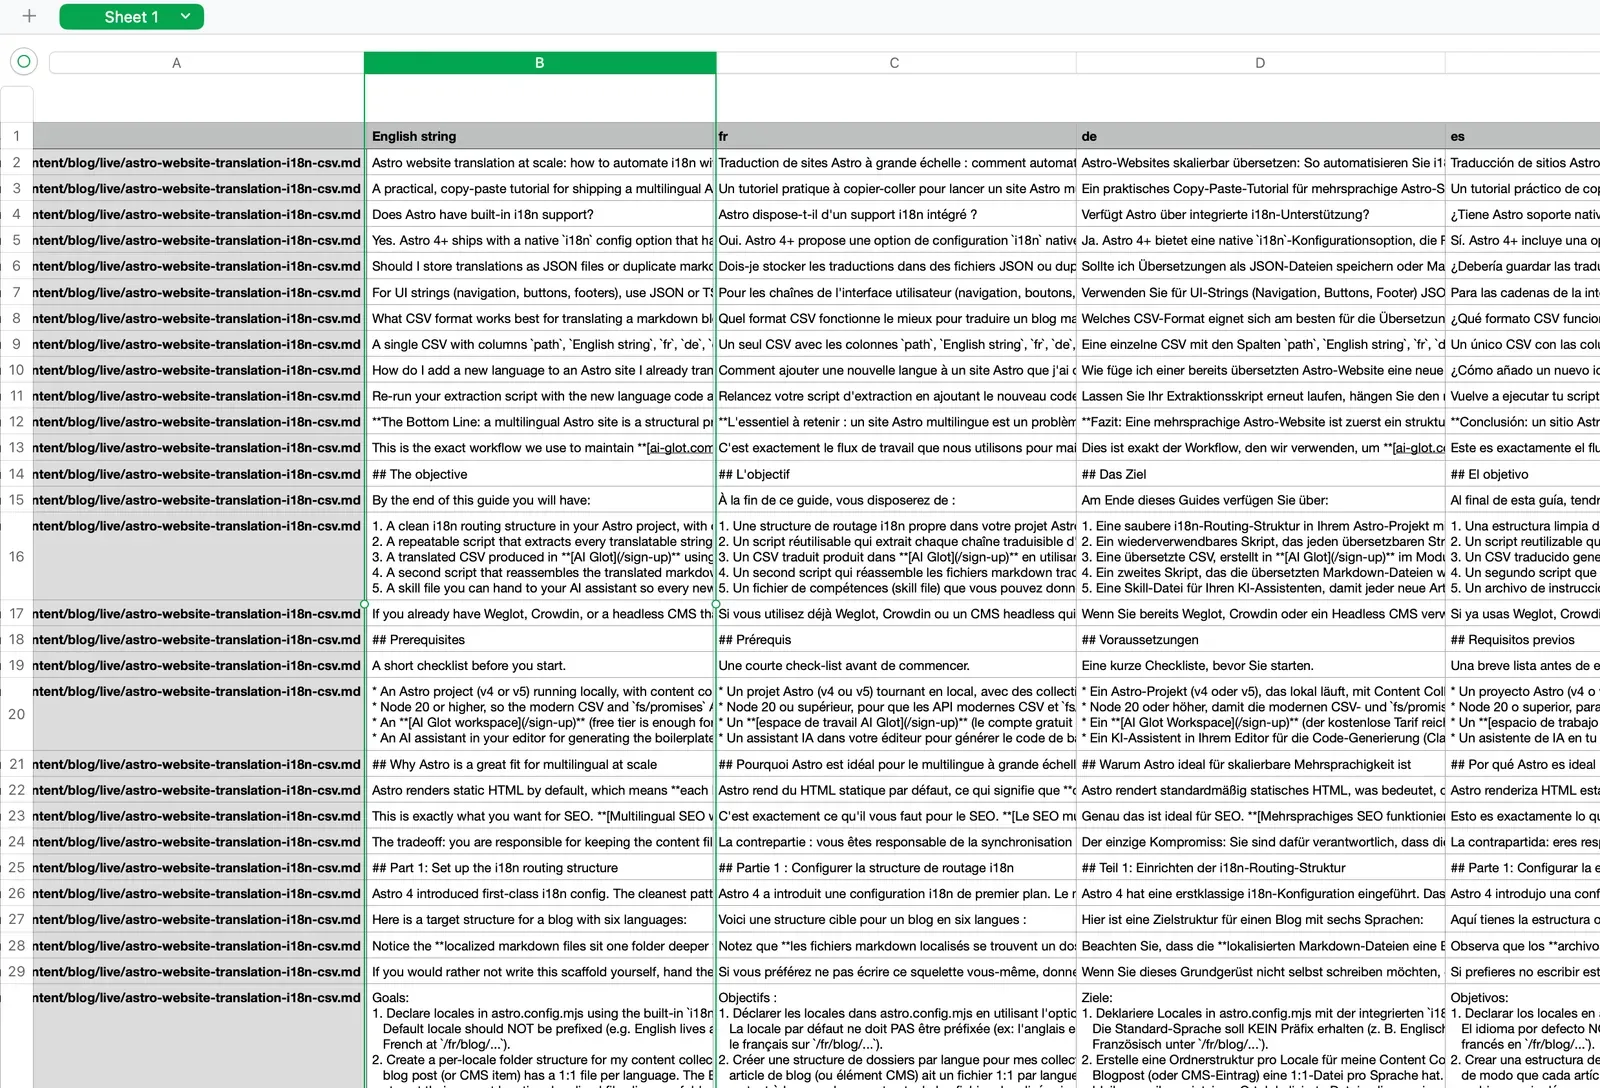
Pourquoi un découpage en blocs ? Parce que la traduction par IA fonctionne bien mieux sur des unités cohérentes de la taille d’un paragraphe que sur des documents complets. Les règles du glossaire s’appliquent uniformément, les budgets de jetons restent prévisibles et, si un bloc nécessite une correction, vous modifiez une seule cellule et non un fichier de 2 000 mots.
Option A : Vous stockez le contenu sous forme de fichiers markdown (blog, docs, pages de destination)
Utilisez ce prompt pour générer un script d’extraction adapté à votre repo. Nous utilisons une version quasi identique pour le site web d’AI Glot.
Write a Node.js script at `scripts/extract-translations.mjs` that prepares a
CSV for bulk translation in AI Glot.
Inputs:
- A source directory containing English markdown files
(e.g. `src/content/blog/live/`).
- A list of target locale codes (e.g. `fr de es it pt`).
- An output CSV path (default `multilang-translation.csv`).
For each markdown file:
1. Parse the frontmatter using `gray-matter`.
2. Extract these translatable strings, one per CSV row:
- `title` (frontmatter)
- `metaDescription` (frontmatter)
- For each entry in `faqs`: the `question` and the `answer` as separate rows.
- Each body paragraph, splitting the markdown body on `\n\n` so paragraphs,
bullet lists, blockquotes, and headings each become one row.
3. SKIP these chunks (do not include them in the CSV):
- Pure image lines starting with `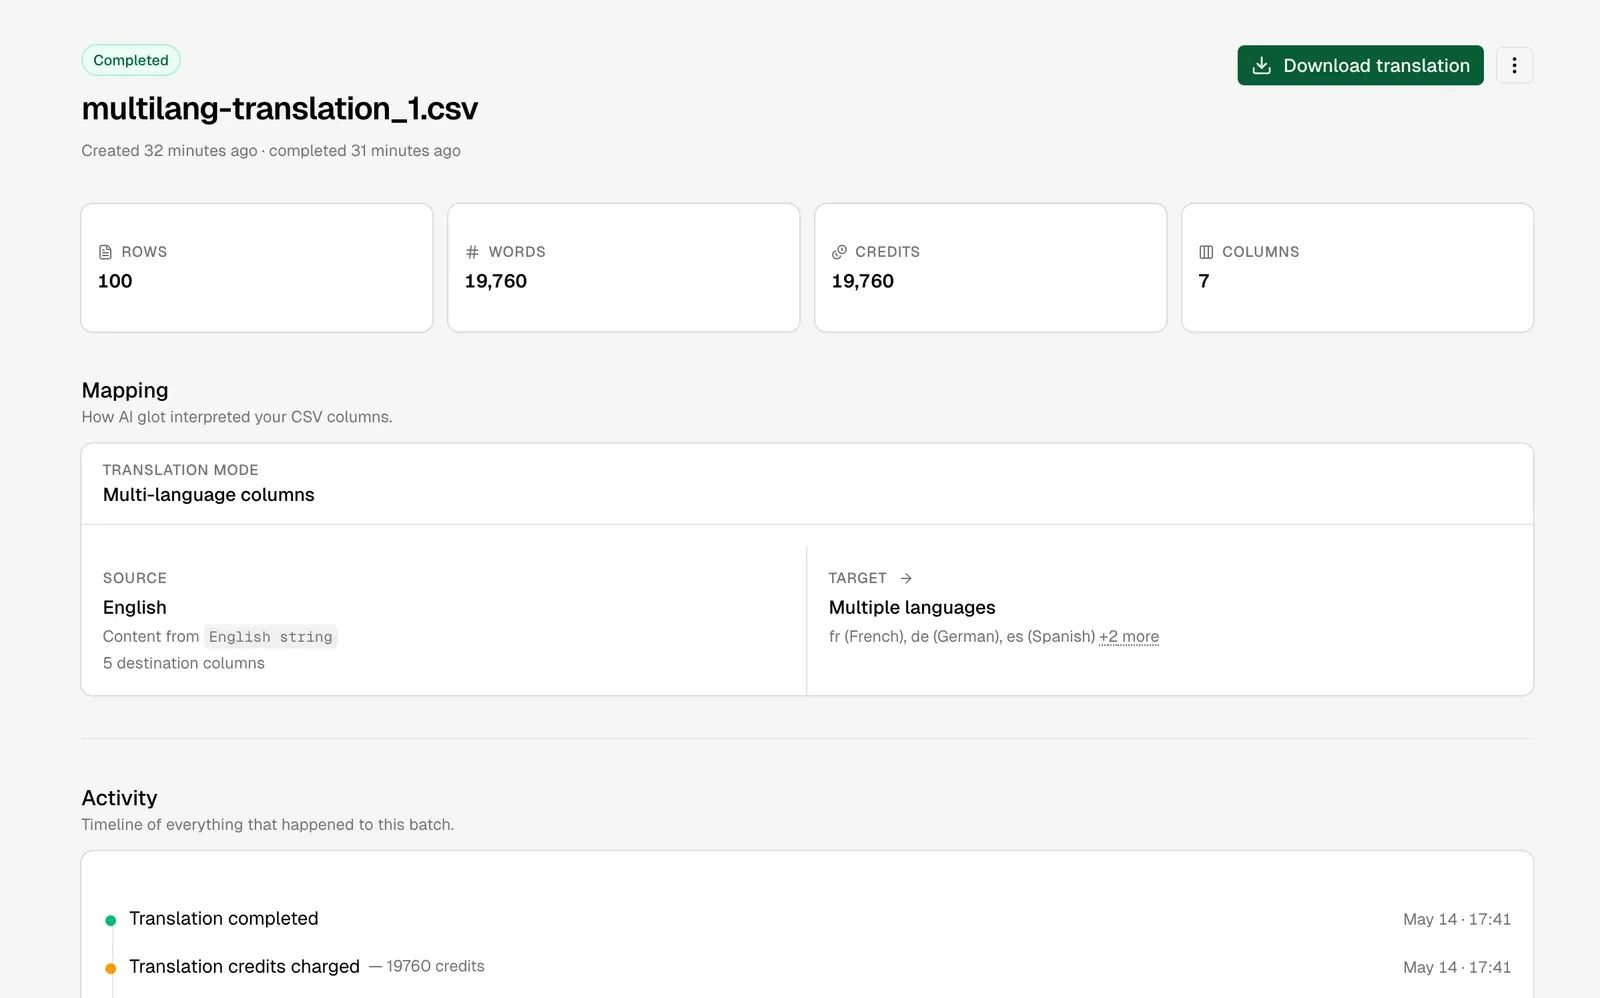
Partie 4 : Réintégrer le markdown traduit dans Astro
Vous disposez maintenant d’un fichier multilang-translation_translated.csv où chaque colonne cible est remplie. L’objectif est de prendre chaque bloc traduit et de le réinjecter dans le bon fichier markdown localisé, en préservant exactement la structure originale.
C’est ici que l’extraction par blocs devient payante. Comme chaque ligne est liée au bloc anglais original, vous pouvez simplement remplacer les blocs anglais par leur version localisée dans le fichier source original, puis enregistrer le résultat dans le dossier de la langue correspondante. Pas d’analyse AST, pas de conversion markdown complexe, et aucun risque de casser le formatage.
Deux corrections structurelles doivent être effectuées lors de la reconstruction :
- Chemins d’accès aux images. Les fichiers anglais référencent les assets via
../../../assets/.... Les fichiers localisés étant situés un niveau de dossier plus bas, le chemin relatif devient../../../../assets/.... - Liens internes. Un lien comme
/blog/glossary-website-translationsen anglais doit devenir/fr/blog/glossary-website-translationsen français (et ainsi de suite pour chaque locale).
Voici le prompt que nous utilisons pour générer le script de reconstruction. Il est assez générique pour être utilisé dans n’importe quel projet Astro suivant la structure de la Partie 1.
Use the unified assembly script at `scripts/assemble-blog-translations.mjs` that rebuilds
localized markdown files from an AI Glot translated CSV.

Inputs (CLI args):
- Path to the translated CSV (e.g. `multilang-translation_translated.csv`)
  with columns `path, English string, fr, de, es, it, pt`.
- The source directory containing the original English markdown files
  (default `src/content/blog/live/`).
- The destination directory pattern for localized files
  (default `src/content/blog/{lang}/live/`).
- The site origin used for internal links (default `https://ai-glot.com`).

For each unique `path` value in the CSV:
1. Read the original English file from `<sourceDir>/<path>`.
2. For each target locale column (everything after `English string`):
   a. Start from the English file's full text.
   b. For every row that matches this `path`, find the `English string`
      verbatim in the file and replace it with the value in the target
      locale column. Use literal string replace, not regex. Throw if the
      English chunk is not found (it means the source drifted from the CSV;
      this should fail loudly rather than silently skip).
   c. After all replacements, run two structural fixes on the resulting text:
      - Image paths: replace every occurrence of `../../../assets/` with
        `../../../../assets/` (one extra `../` because localized files live
        one folder deeper).
      - Internal links: replace every absolute internal URL on this site
        (e.g. `https://ai-glot.com/blog/...`) and every root-relative path
        (e.g. `/blog/...`, `/sign-up`) with the locale-prefixed equivalent
        (`/fr/blog/...`, `/fr/sign-up`). Skip anchors (`#...`), external URLs,
        and `mailto:` / `tel:` links.
   d. Write the file to `<destDir resolved with this lang>/<path>`. Create
      directories as needed.
3. After processing all paths, print a summary: files written per locale,
   total replacements, any chunks that could not be found.

Robustness:
- Use `papaparse` to read the CSV. Trim BOM if present.
- Preserve the exact frontmatter formatting (delimiters, key order, quoting).
  The simplest way is to do replacements on the raw file string, not on a
  parsed AST.
- Be idempotent: running the script twice on the same inputs produces the
  same outputs.

Make it a single self-contained file. Usage:
`node scripts/assemble-blog-translations.mjs translated.csv`
Lancez le script et vous verrez apparaître une série de nouveaux fichiers sous src/content/blog/fr/live/, src/content/blog/de/live/, etc. Vérifiez-en un, lancez astro dev, et vos routes localisées devraient s’afficher instantanément.
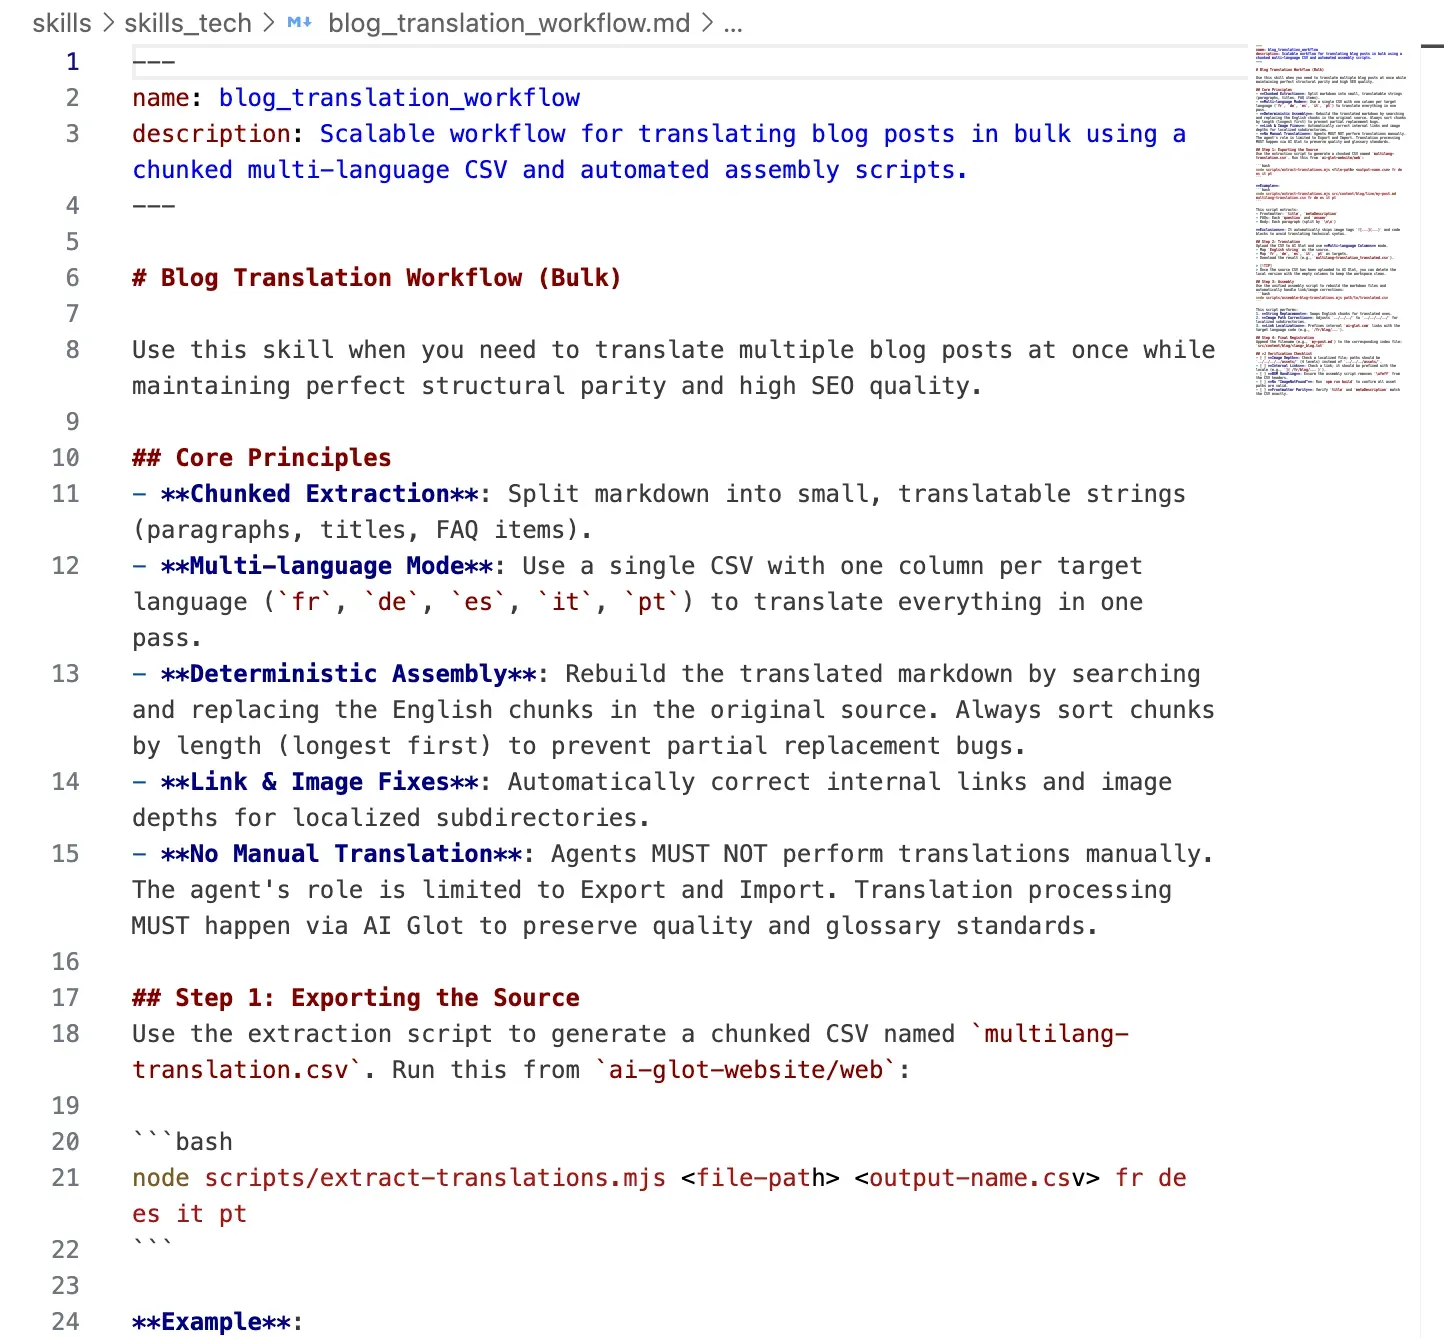
Bonus 1 : Un fichier de compétences pour que chaque nouvel article soit “traduisible par défaut”
Une fois que le pipeline fonctionne, vous voulez que chaque futur article suive le même processus. L’astuce : stockez la convention dans un fichier de compétences que votre assistant IA lira avant de rédiger tout nouvel article.
Si vous utilisez Claude Code, Cursor ou tout autre éditeur IA qui charge des instructions au niveau du projet, placez ce fichier dans votre repo sous skills/blog_translation_workflow.md. C’est exactement ce modèle que nous utilisons chez AI Glot.
---
name: blog_translation_workflow
description: How to ship a new blog post so it can be translated in bulk later.
---

# Blog translation workflow

When writing a new blog post or CMS item, follow these conventions so it
flows cleanly through the multilingual extraction pipeline.

## 1. File location and naming
- Drafts live under `src/content/blog/draft/`.
- Slug = filename = the same string used in `slug:` frontmatter.
- Move to `src/content/blog/live/` only after review.

## 2. Frontmatter contract
Every post MUST have:
- `title`: sentence case, no trailing period.
- `metaDescription`: 140 to 160 characters, full sentence.
- `coverImage`: relative path from this file's location.
- `publishedDate`: ISO date.
- `slug`: matches the filename.
- `faqs`: array of `{ question, answer }`. Minimum 3 items.

## 3. Body structure that translates well
- Use sentence-case headings (no Title Case).
- Keep paragraphs to 1 to 4 sentences. Each paragraph becomes one CSV row,
  so shorter paragraphs translate more reliably.
- Never put two images back to back; always separate them with at least one
  paragraph of explanatory text.
- Internal links use root-relative paths (`/blog/...`, `/sign-up`).
- Image paths use `../../../assets/...` (English depth).

## 4. After publishing
Run:
```bash
node scripts/extract-translations.mjs src/content/blog/live/`<slug>`.md \
  multilang-translation.csv fr de es it pt
```
to append this article's translatable chunks to the master CSV. Upload the
CSV to AI Glot and ask it to fill every language column, then run:
```bash
node scripts/assemble-blog-translations.mjs multilang-translation_translated.csv
```
to generate the localized markdown files.

## 5. Anti-patterns
- Do NOT use em-dashes; use commas or colons.
- Do NOT bold entire paragraphs. Bold key phrases only.
- Do NOT skip an FAQ section; FAQs are among the highest-value SEO blocks.
- Do NOT inline raw HTML inside markdown unless absolutely necessary;
  it complicates chunk-based reassembly.
La prochaine fois que vous (ou un membre de votre équipe) écrirez un article, l’assistant lira ce fichier en priorité et produira un texte parfaitement adapté au pipeline, sans nettoyage manuel.
Bonus 2 : Ajouter une nouvelle langue à tout votre blog en un seul lot
C’est la partie qui surprend le plus. Une fois le pipeline en place, ajouter une nouvelle langue se résume à une seule opération CSV pour l’ensemble de vos archives de blog.
Imaginons que vous ayez 80 articles traduits en français, allemand, espagnol, italien et portugais, et que vous décidiez d’ajouter le néerlandais.
Le flux de travail :
- Relancez votre script d’extraction en ajoutant
nlà la liste des locales. Comme le script lit le dossier source anglais, tous les articles (anciens et nouveaux) sont inclus. - Ouvrez le CSV. La colonne
English stringest identique à la précédente. Les colonnesfr, de, es, it, ptsont toujours vides (le script ne regarde pas les traductions existantes, il construit simplement la matrice vide). La colonnenlest nouvelle et vide. - Supprimez les colonnes que vous n’avez pas besoin de retraduire. Effacez
fr, de, es, it, ptdu tableur, et gardezpath, English string, nl. - Importez le fichier dans AI Glot et demandez-lui de traduire
English stringuniquement vers lenl. - Lancez le script de réassemblage avec le nouveau CSV. Il écrit chaque article dans
src/content/blog/nl/live/.
Vous êtes passé de “nous devons ajouter le néerlandais” à “le néerlandais est en ligne” en un seul import. Pour 80 articles. C’est ça, quand le flux de travail fait le gros du travail, et non l’équipe.
Le même modèle fonctionne pour des modifications ponctuelles : modifiez un seul paragraphe en anglais, réexportez uniquement les fragments concernés, traduisez-les et reconstruisez. Les mises à jour restent économiques car le pipeline est structurel, et non basé sur des documents.
Liste de vérification
Avant de déployer en production, effectuez un contrôle de cohérence pour chaque locale :
npm run build(ouastro build) s’exécute sans erreurImageNotFound.- Survolez le sélecteur de langue d’un article localisé et confirmez que l’URL reste propre.
- Ouvrez un article en français et vérifiez rapidement : titre, méta-description, trois premiers paragraphes, une réponse FAQ. Comparez avec la source.
- Cliquez sur un lien interne dans l’article français. Il doit vous mener vers une autre page française, et non revenir vers l’anglais.
- Inspectez le
<head>pour vérifier la présence des annotationshreflangcorrectes pour toutes les locales. - Lancez un audit Lighthouse sur une URL localisée ; le score SEO doit être identique à celui de l’équivalent anglais.
Si l’un de ces points échoue, les causes les plus fréquentes sont : une profondeur de chemin d’image incorrecte, un lien interne qui a échappé à la regex, ou un fragment qui a dérivé entre l’extraction et le réassemblage. Les avertissements “could not find chunk” du script de réassemblage vous indiquent exactement où regarder.
Ce qu’il faut retenir
Traiter un site Astro multilingue comme un pipeline de contenu, plutôt que comme un projet de traduction ponctuel, est la clé de sa maintenabilité. Mettez en place le bon pipeline (routage des locales, extraction CSV par blocs, traduction via AI Glot, réassemblage déterministe) et la traduction d’un nouvel article, la correction d’un paragraphe ou l’ajout d’une nouvelle langue devient une opération routinière plutôt qu’une initiative trimestrielle.
Les éléments clés pour réussir :
- L’i18n native d’Astro pour des pages statiques propres par locale.
- Un petit script d’extraction qui transforme le markdown en CSV traduisible.
- La traduction CSV d’AI Glot, configurée en une phrase pour remplir toutes les colonnes de langue en une seule passe, avec contrôle du glossaire et des instructions.
- Un script de réassemblage qui gère la profondeur des images et la localisation des liens internes.
- Un fichier de compétences pour que chaque nouvel article s’intègre au pipeline par défaut.
Prêt à passer au multilingue ? Inscrivez-vous à AI Glot, importez votre premier fichier CSV d’extraction et voyez votre blog publié en six langues d’ici la fin de l’après-midi.