Conclusão: um site Astro multilíngue é um problema estrutural antes de ser um problema de tradução. Configure pastas de conteúdo limpas por localidade, extraia cada trecho traduzível para um único CSV, peça ao AI Glot em uma frase para preencher cada coluna de idioma, usando a tradução de CSV do AI Glot, e então remonte os arquivos programaticamente. Uma vez que o pipeline está pronto, adicionar um novo idioma é uma operação de um único CSV.
Este é o fluxo de trabalho exato que usamos para manter o ai-glot.com em seis idiomas (inglês, francês, alemão, espanhol, italiano, português) sem reescrever um único post de blog manualmente. Vamos percorrer todo o processo, com os prompts que usamos para estruturar cada etapa com um assistente de codificação de IA como o Claude Code ou Cursor.
O objetivo
Ao final deste guia, você terá:
- Uma estrutura de roteamento i18n limpa em seu projeto Astro, com uma pasta por idioma.
- Um script repetível que extrai cada string traduzível de um arquivo markdown (ou exportação de CMS) para um único CSV.
- Um CSV traduzido produzido no AI Glot, preenchido em uma única passagem em todas as colunas de idioma.
- Um segundo script que remonta os arquivos markdown traduzidos, com caminhos de imagem e links internos corrigidos para os subdiretórios localizados.
- Um arquivo de instruções que você pode entregar ao seu assistente de IA para que cada novo artigo já nasça traduzível por padrão.
Se você já usa Weglot, Crowdin ou um CMS headless que exporta CSV, pode pular o script de extração de markdown e enviar essas exportações diretamente para o AI Glot. A lógica de tradução e remontagem é a mesma para qualquer projeto de tradução de conteúdo de CMS.
Pré-requisitos
Um checklist rápido antes de começar.
- Um projeto Astro (v4 ou v5) rodando localmente, com coleções de conteúdo configuradas para seu blog.
- Node 20 ou superior, para que as APIs modernas de CSV e
fs/promisesfuncionem corretamente. - Uma conta no AI Glot (o plano gratuito é suficiente para o primeiro lote).
- Um assistente de IA no seu editor para gerar o código base (Claude Code, Cursor, Copilot, Codeium, você escolhe).
Por que o Astro é ideal para multilíngue em escala
O Astro renderiza HTML estático por padrão, o que significa que cada página localizada é apenas um arquivo no disco. Não há camada de tradução em tempo de execução, nem consulta ao banco de dados para troca de idioma, nem pacote JavaScript para baixar por localidade. O Google indexa cada versão de idioma como uma URL distinta com suas próprias meta tags, e a saída do build é essencialmente um espelho traduzido da sua árvore em inglês.
Isso é exatamente o que você quer para SEO. O SEO multilíngue funciona melhor quando cada idioma tem sua própria página gerada estaticamente e rastreável, com anotações hreflang adequadas e uma estrutura de URL limpa. O Astro oferece isso gratuitamente.
A contrapartida: você é responsável por manter os arquivos de conteúdo sincronizados entre os idiomas. Esse é precisamente o problema que o pipeline de CSV abaixo resolve.
Parte 1: Configure a estrutura de roteamento i18n
O Astro 4 introduziu a configuração de i18n nativa. O padrão mais limpo é declarar seus locales, definir o padrão como sem prefixo (assim, o inglês fica em /blog/my-post e o francês em /fr/blog/my-post) e espelhar suas coleções de conteúdo em uma pasta [lang]/ por idioma.
Aqui está uma estrutura sugerida para um blog com seis idiomas:
src/
  content/
    blog/
      live/                          # English (default locale)
        my-first-post.md
      fr/live/                       # French
        my-first-post.md
      de/live/                       # German
        my-first-post.md
      es/live/                       # Spanish
        my-first-post.md
      it/live/                       # Italian
        my-first-post.md
      pt/live/                       # Portuguese
        my-first-post.md
  pages/
    blog/[slug].astro                # English routes
    [lang]/blog/[slug].astro         # Localized routes
  i18n/
    ui.ts                            # UI string dictionary per locale
Observe que os arquivos markdown localizados ficam em uma pasta mais profunda que os em inglês. Essa profundidade é importante: caminhos de imagem relativos em markdowns localizados precisam de um ../ extra para chegar em src/assets/. O script de remontagem na Parte 4 resolve isso automaticamente.
Se você preferir não escrever essa estrutura sozinho, envie o seguinte prompt para o seu assistente de codificação por IA. Ele é intencionalmente genérico para funcionar em qualquer projeto Astro e faz as perguntas de esclarecimento corretas antes de gerar o código.
You are helping me scaffold internationalization (i18n) in an existing Astro
project. I want to translate my entire site into multiple languages while
keeping clean URLs, proper hreflang annotations, and per-locale static pages.

Goals:
1. Declare locales in astro.config.mjs using the built-in `i18n` option.
   Default locale should NOT be prefixed (e.g. English lives at `/blog/...`,
   French at `/fr/blog/...`).
2. Create a per-locale folder structure for my content collections so each
   blog post (or CMS item) has a 1:1 file per language. The English files
   stay at their current location; localized files live one folder deeper
   (e.g. `src/content/blog/fr/live/`).
3. Add a typed UI string dictionary at `src/i18n/ui.ts` that exports an object
   keyed by locale, plus a `useTranslations(lang)` helper.
4. Update the content collection schema so the same Zod definition applies to
   every language folder.
5. Generate the dynamic route file `src/pages/[lang]/blog/[slug].astro` that
   reads from the localized content collection and falls back to English when
   a localized version is missing.
6. Add a `<LanguageSwitcher />` component that renders an anchor per locale,
   preserving the current pathname.
7. Inject `<link rel="alternate" hreflang="..." />` tags into the layout for
   every locale that has the page available.

Before you generate any code, ask me:
- The list of target locales (BCP 47 codes) and which one is the default.
- The path to my existing content collection(s) and current route files.
- Whether I want a language switcher in the header, footer, or both.
- Whether I store UI strings in JSON, TS, or somewhere else today.

Then make the changes in small, surgical commits. Do not refactor unrelated
code. Show me the diff and explain any decision where there are two valid
patterns (e.g. prefixed vs. non-prefixed default locale).
Esse padrão é intencional: esclarecer, depois construir. Tentamos a abordagem de “apenas gerar tudo” no início e acabamos com três componentes de alternador de idioma diferentes e um esquema de roteamento que conflitava com nosso esquema de coleção de conteúdo. Pedir para o assistente perguntar primeiro economiza uma hora de limpeza depois.
Parte 2: Extraia seu conteúdo para um CSV de tradução
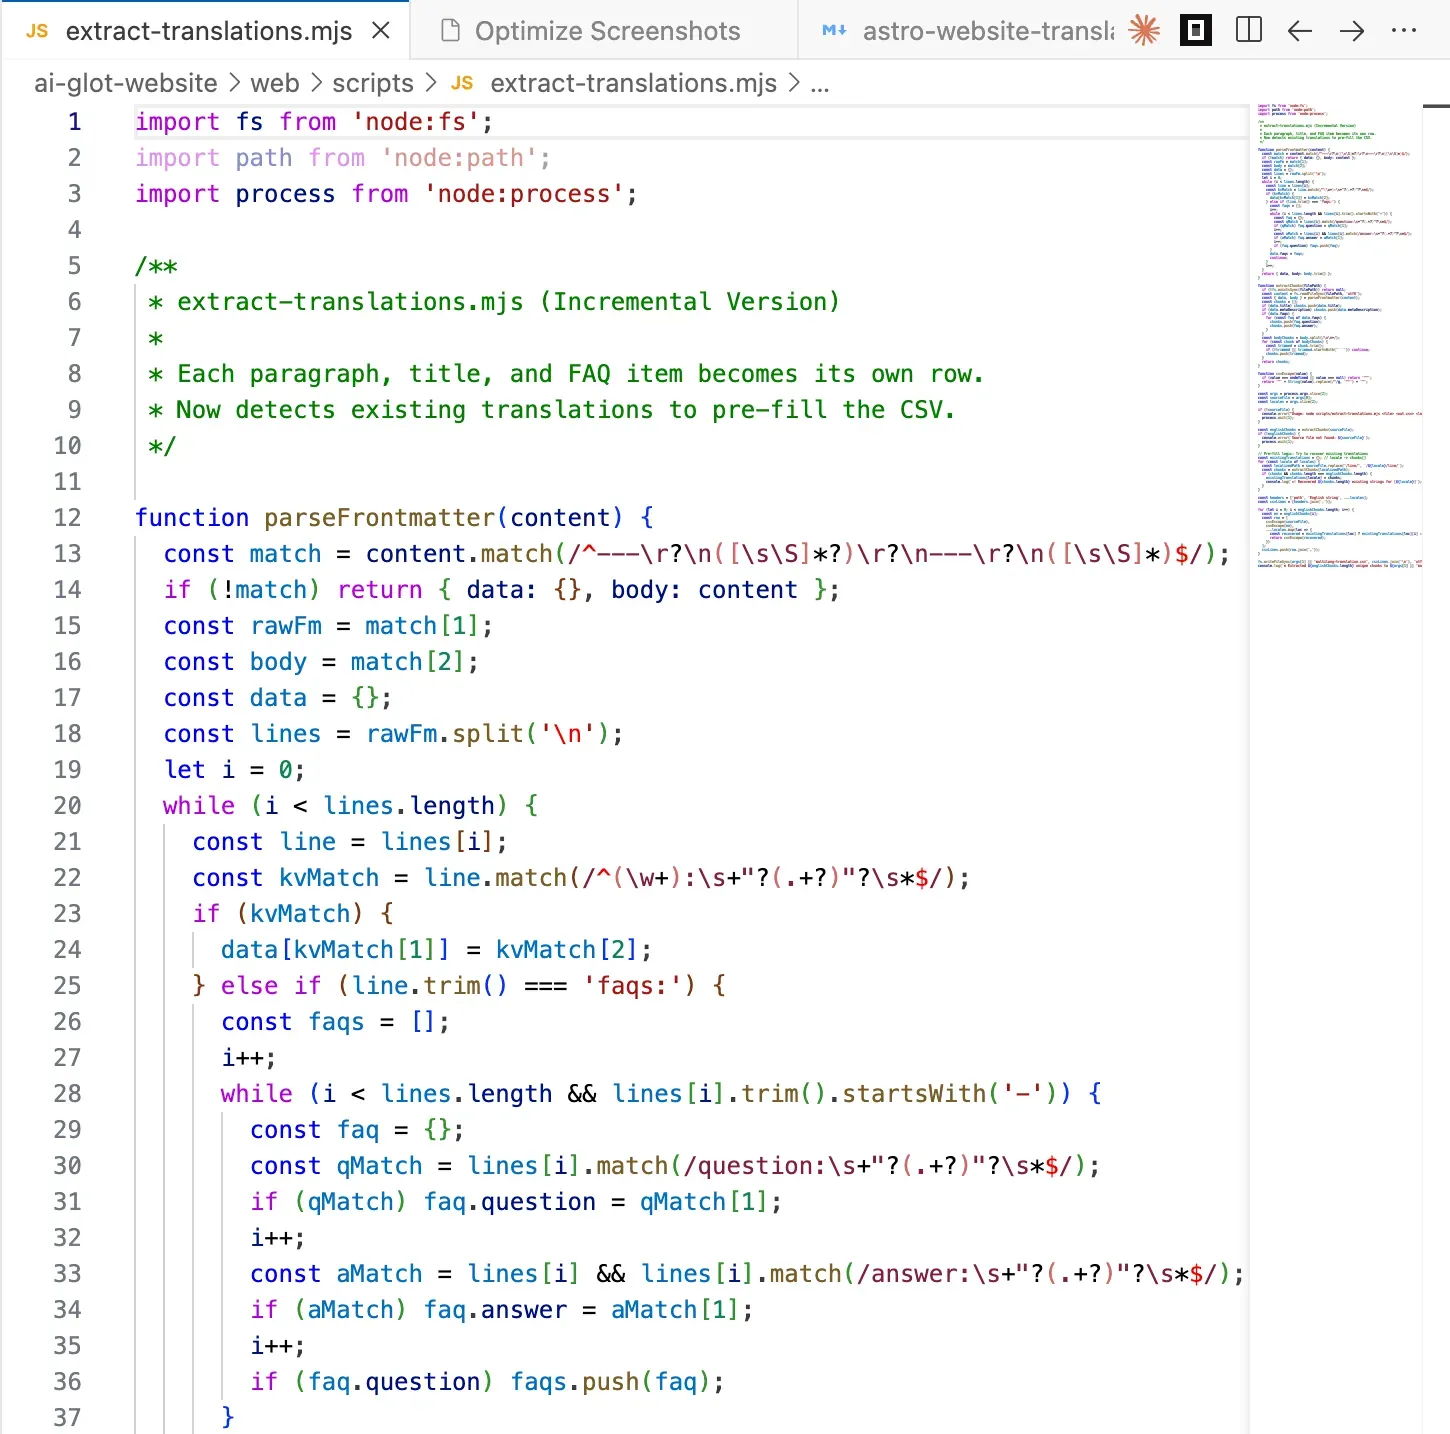
É aqui que a maioria das equipes trava. A tradução em si é a parte fácil. Colocar seu conteúdo dentro e fora de uma ferramenta de tradução sem quebrar a estrutura é a parte difícil.
O truque que faz isso funcionar bem no AI Glot é a extração fragmentada. Você divide cada arquivo markdown nas menores unidades traduzíveis significativas (um campo de frontmatter, um par de FAQ, um único parágrafo), escreve cada fragmento como uma linha em um CSV e adiciona uma coluna por idioma de destino. O resultado fica assim:
| path | English string | fr | de | es | it | pt |
|---|---|---|---|---|---|---|
| live/my-first-post.md | How to translate an Astro website at scale into many languages | |||||
| live/my-first-post.md | A practical, copy-paste tutorial for shipping a multilingual Astro site. | |||||
| live/my-first-post.md | Astro renders static HTML by default, which means each localized page is just a file on disk. |
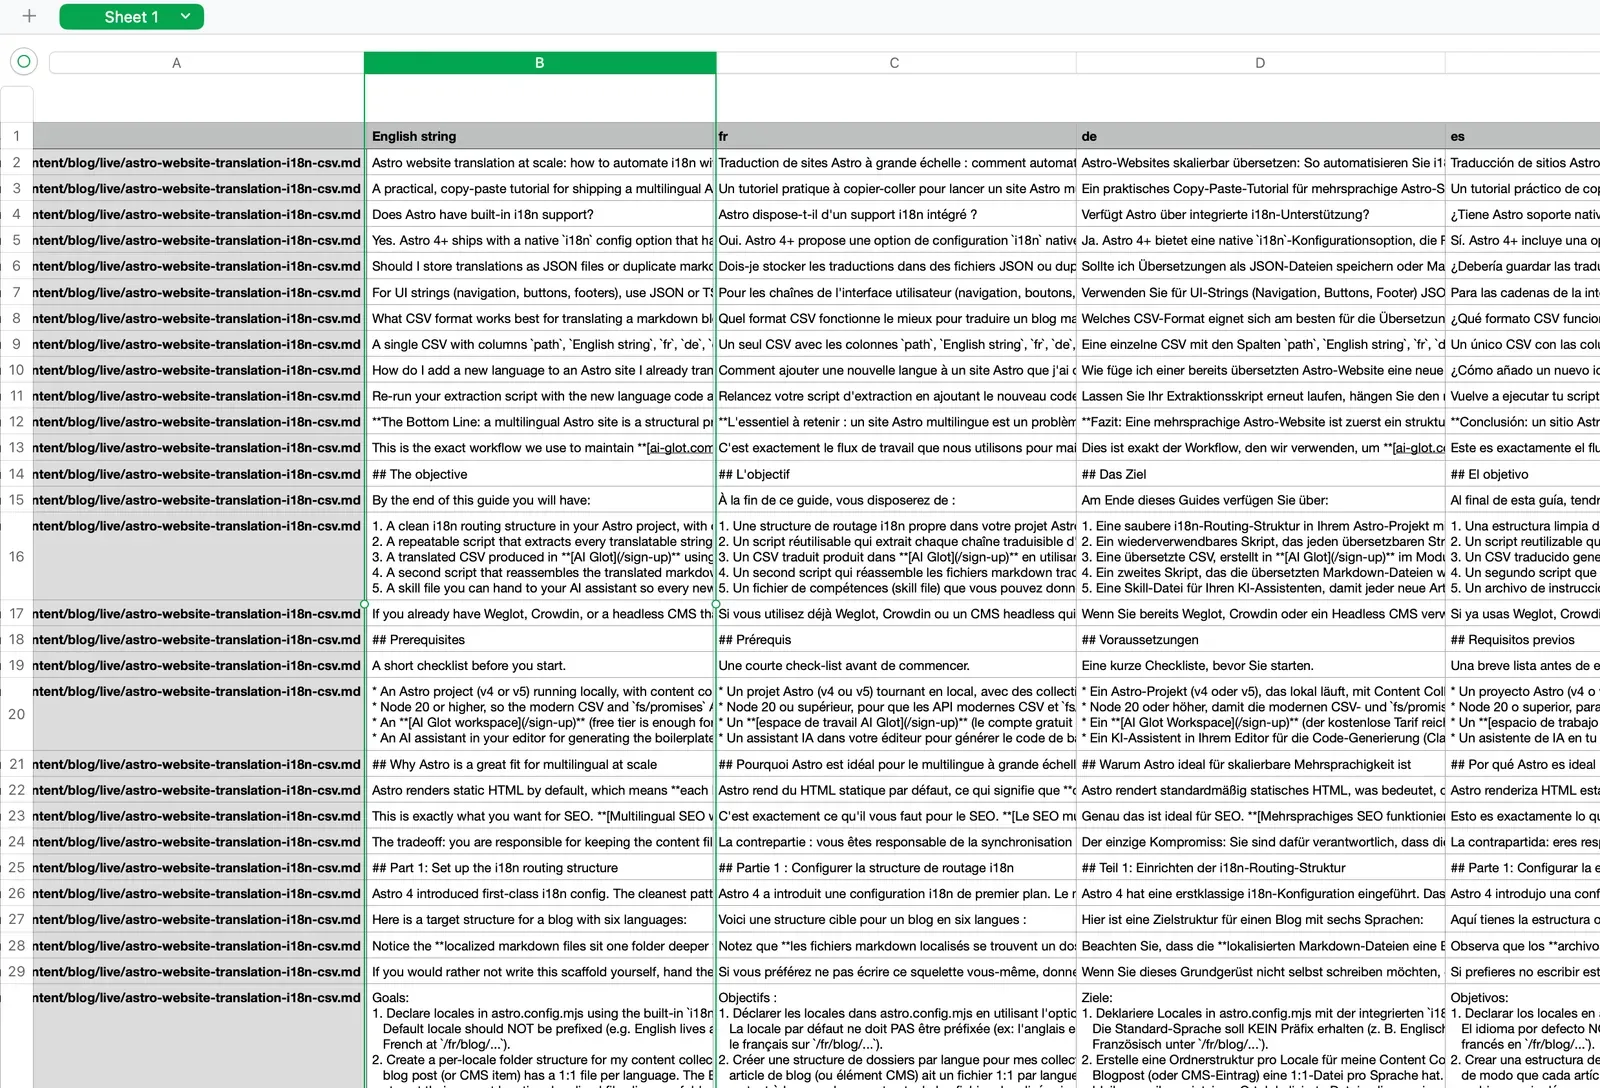
Por que em blocos? Porque a tradução por IA funciona muito melhor em unidades coerentes do tamanho de um parágrafo do que em documentos inteiros. As regras do glossário são aplicadas de forma consistente, o orçamento de tokens permanece previsível e, se um bloco precisar de correção, você edita uma única célula, não um arquivo de 2.000 palavras.
Opção A: Você armazena o conteúdo como arquivos markdown (blog, docs, landing pages)
Use este prompt para gerar um script de extração adaptado ao seu repositório. Usamos uma versão quase idêntica para o site do AI Glot.
Write a Node.js script at `scripts/extract-translations.mjs` that prepares a
CSV for bulk translation in AI Glot.
Inputs:
- A source directory containing English markdown files
(e.g. `src/content/blog/live/`).
- A list of target locale codes (e.g. `fr de es it pt`).
- An output CSV path (default `multilang-translation.csv`).
For each markdown file:
1. Parse the frontmatter using `gray-matter`.
2. Extract these translatable strings, one per CSV row:
- `title` (frontmatter)
- `metaDescription` (frontmatter)
- For each entry in `faqs`: the `question` and the `answer` as separate rows.
- Each body paragraph, splitting the markdown body on `\n\n` so paragraphs,
bullet lists, blockquotes, and headings each become one row.
3. SKIP these chunks (do not include them in the CSV):
- Pure image lines starting with `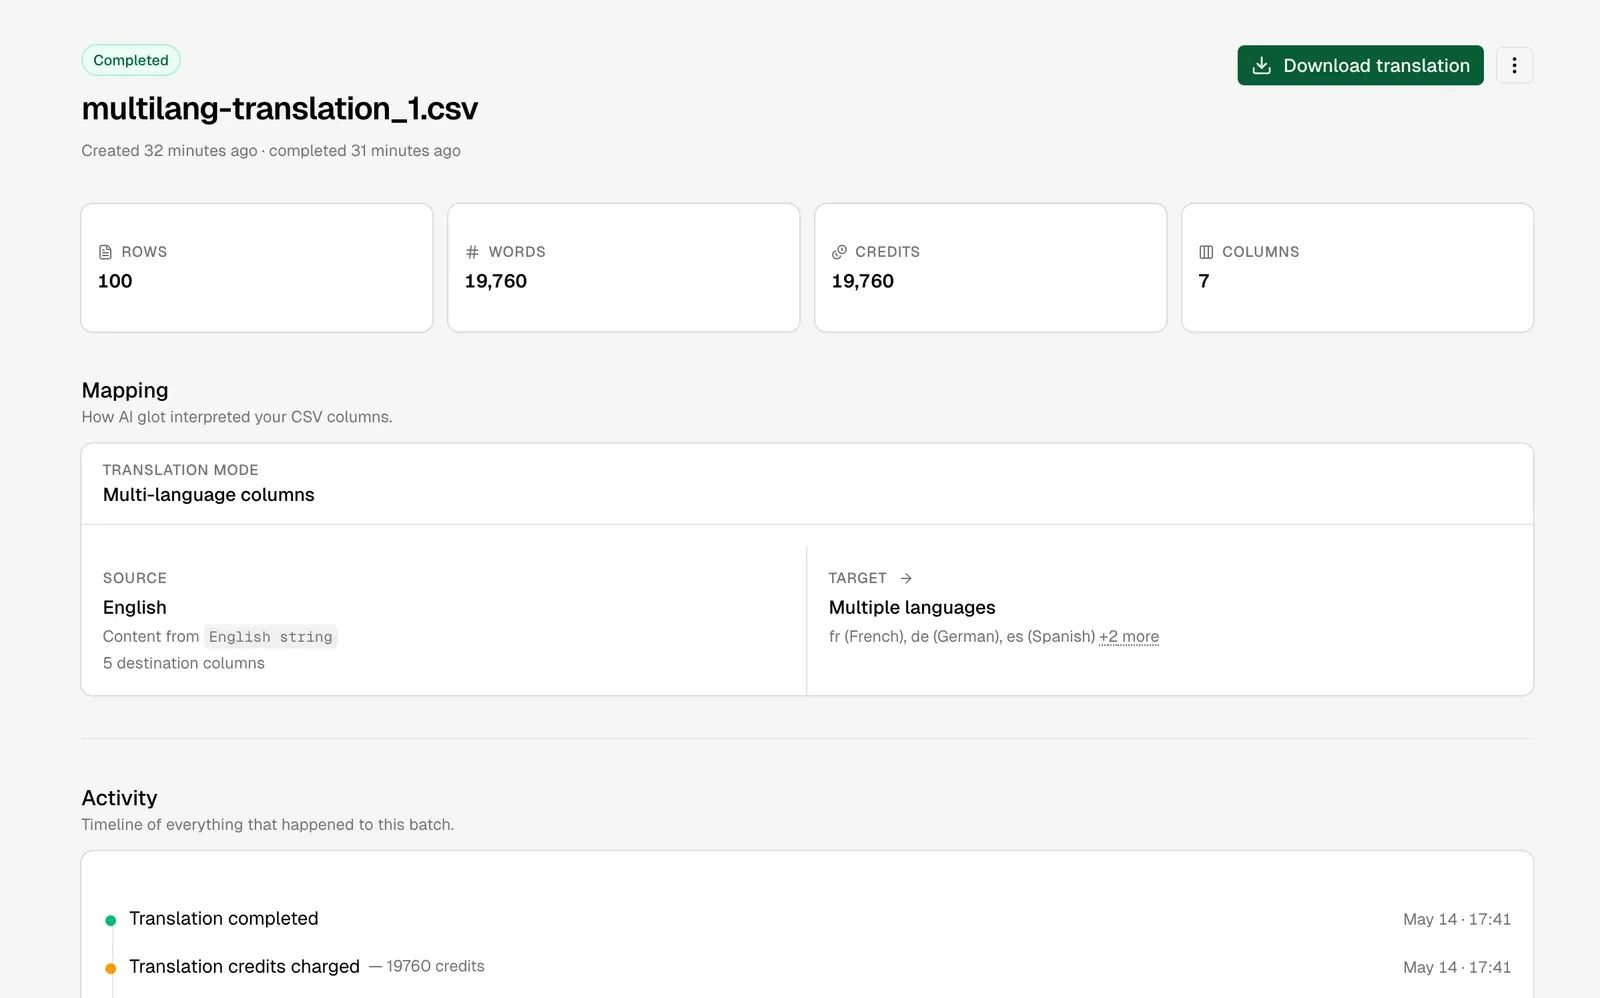
Parte 4: Remonte o markdown traduzido de volta no Astro
Agora você tem um multilang-translation_translated.csv com todas as colunas de destino preenchidas. O objetivo é pegar cada trecho traduzido e escrevê-lo de volta no arquivo markdown localizado correto, preservando a estrutura original exatamente como era.
É aqui que a extração em blocos se paga novamente. Como cada linha é vinculada ao trecho original em inglês, você pode simplesmente localizar e substituir os trechos em inglês por suas contrapartes localizadas dentro do arquivo de origem original e salvar o resultado na pasta localizada. Sem parsing de AST, sem conversões complexas de markdown e sem risco de quebrar a formatação.
Duas correções estruturais devem ocorrer durante a remontagem:
- Caminhos de imagem. Arquivos em inglês referenciam assets com
../../../assets/.... Arquivos localizados ficam em uma pasta mais profunda, portanto, o caminho relativo torna-se../../../../assets/.... - Links internos. Um link como
/blog/glossary-website-translationsem inglês precisa se tornar/fr/blog/glossary-website-translationsem francês (e assim por diante para cada localidade).
Aqui está o prompt que usamos para gerar o script de remontagem. Ele é genérico o suficiente para ser usado em qualquer projeto Astro que siga a estrutura da Parte 1.
Use the unified assembly script at `scripts/assemble-blog-translations.mjs` that rebuilds
localized markdown files from an AI Glot translated CSV.

Inputs (CLI args):
- Path to the translated CSV (e.g. `multilang-translation_translated.csv`)
  with columns `path, English string, fr, de, es, it, pt`.
- The source directory containing the original English markdown files
  (default `src/content/blog/live/`).
- The destination directory pattern for localized files
  (default `src/content/blog/{lang}/live/`).
- The site origin used for internal links (default `https://ai-glot.com`).

For each unique `path` value in the CSV:
1. Read the original English file from `<sourceDir>/<path>`.
2. For each target locale column (everything after `English string`):
   a. Start from the English file's full text.
   b. For every row that matches this `path`, find the `English string`
      verbatim in the file and replace it with the value in the target
      locale column. Use literal string replace, not regex. Throw if the
      English chunk is not found (it means the source drifted from the CSV;
      this should fail loudly rather than silently skip).
   c. After all replacements, run two structural fixes on the resulting text:
      - Image paths: replace every occurrence of `../../../assets/` with
        `../../../../assets/` (one extra `../` because localized files live
        one folder deeper).
      - Internal links: replace every absolute internal URL on this site
        (e.g. `https://ai-glot.com/blog/...`) and every root-relative path
        (e.g. `/blog/...`, `/sign-up`) with the locale-prefixed equivalent
        (`/fr/blog/...`, `/fr/sign-up`). Skip anchors (`#...`), external URLs,
        and `mailto:` / `tel:` links.
   d. Write the file to `<destDir resolved with this lang>/<path>`. Create
      directories as needed.
3. After processing all paths, print a summary: files written per locale,
   total replacements, any chunks that could not be found.

Robustness:
- Use `papaparse` to read the CSV. Trim BOM if present.
- Preserve the exact frontmatter formatting (delimiters, key order, quoting).
  The simplest way is to do replacements on the raw file string, not on a
  parsed AST.
- Be idempotent: running the script twice on the same inputs produces the
  same outputs.

Make it a single self-contained file. Usage:
`node scripts/assemble-blog-translations.mjs translated.csv`
Execute o script e você verá novos arquivos surgindo em src/content/blog/fr/live/, src/content/blog/de/live/, e assim por diante. Verifique um deles, execute astro dev e suas rotas localizadas devem ser renderizadas instantaneamente.
Bônus 1: Um arquivo de habilidade para que cada novo artigo seja “traduzível por padrão”
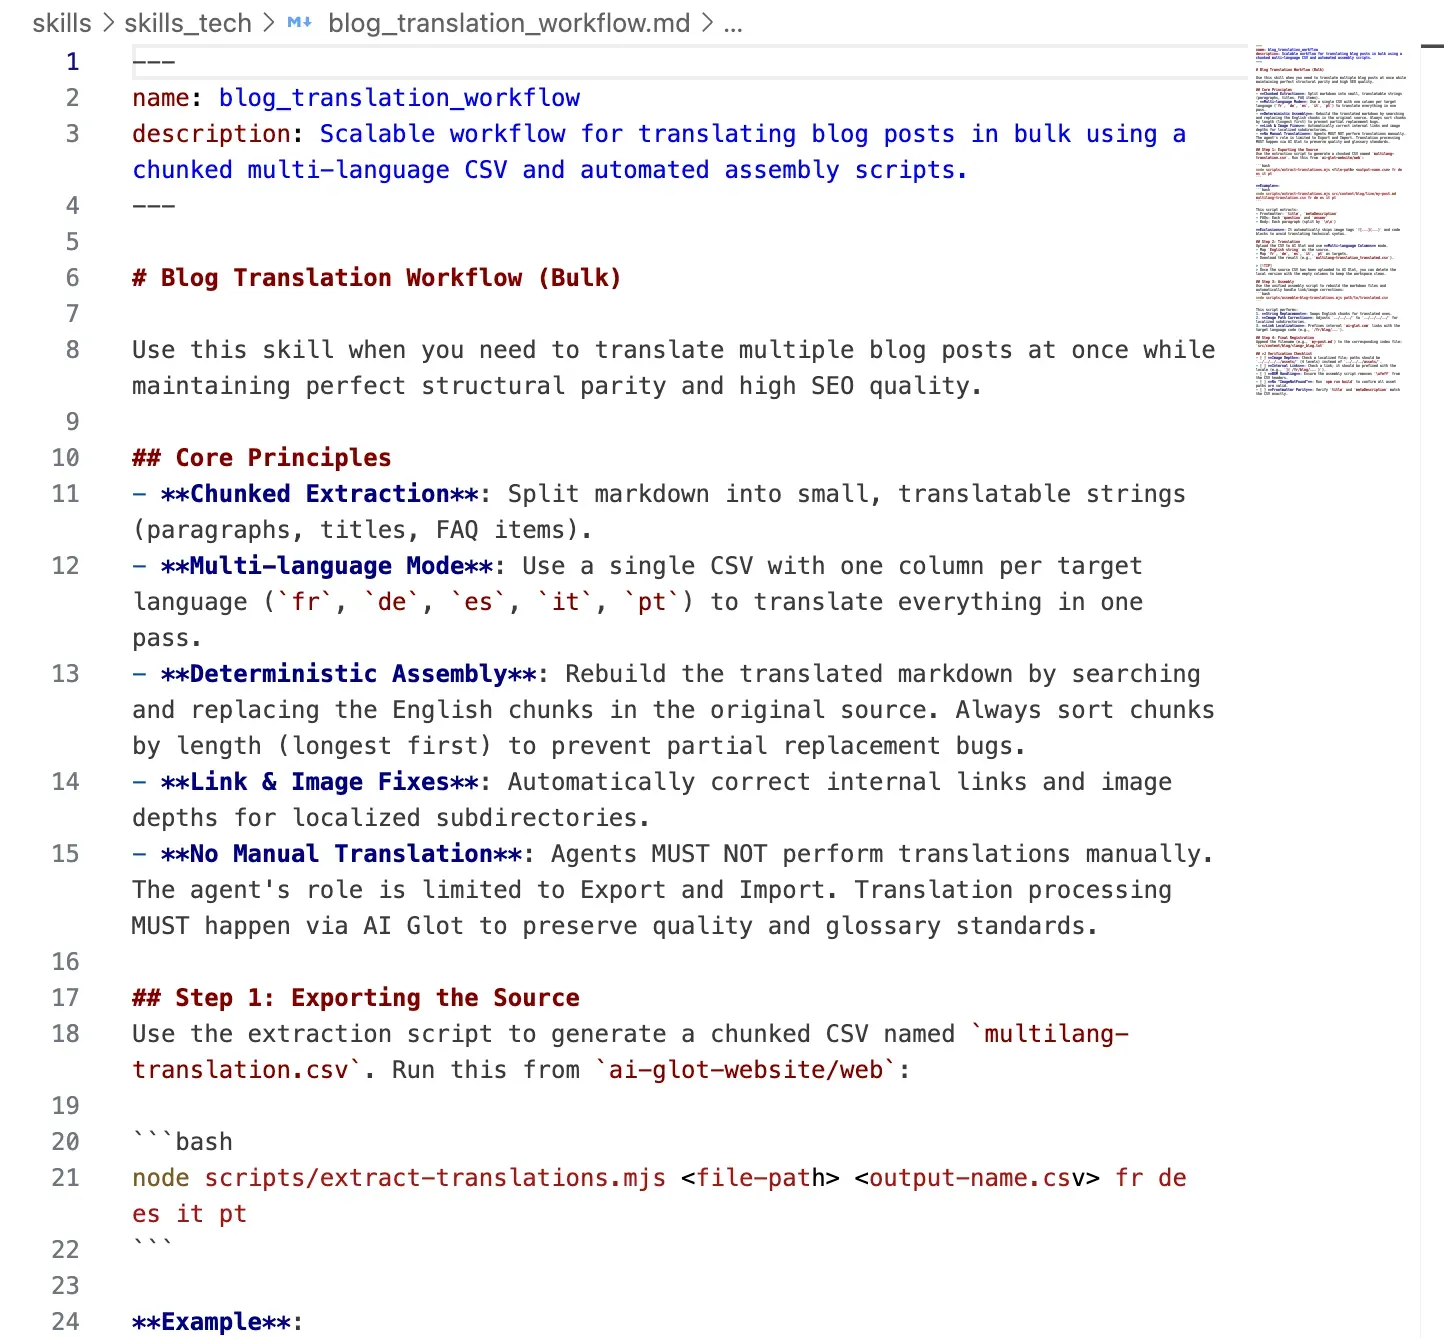
Assim que o pipeline estiver funcionando, você vai querer que todos os artigos futuros sigam o mesmo fluxo. O truque: armazene a convenção em um arquivo de habilidade que seu assistente de IA leia antes de escrever qualquer post novo.
Se você usa Claude Code, Cursor ou qualquer editor de IA que carregue instruções em nível de projeto, coloque este arquivo no seu repositório como skills/blog_translation_workflow.md. Nós usamos exatamente esse padrão no AI Glot.
---
name: blog_translation_workflow
description: How to ship a new blog post so it can be translated in bulk later.
---

# Blog translation workflow

When writing a new blog post or CMS item, follow these conventions so it
flows cleanly through the multilingual extraction pipeline.

## 1. File location and naming
- Drafts live under `src/content/blog/draft/`.
- Slug = filename = the same string used in `slug:` frontmatter.
- Move to `src/content/blog/live/` only after review.

## 2. Frontmatter contract
Every post MUST have:
- `title`: sentence case, no trailing period.
- `metaDescription`: 140 to 160 characters, full sentence.
- `coverImage`: relative path from this file's location.
- `publishedDate`: ISO date.
- `slug`: matches the filename.
- `faqs`: array of `{ question, answer }`. Minimum 3 items.

## 3. Body structure that translates well
- Use sentence-case headings (no Title Case).
- Keep paragraphs to 1 to 4 sentences. Each paragraph becomes one CSV row,
  so shorter paragraphs translate more reliably.
- Never put two images back to back; always separate them with at least one
  paragraph of explanatory text.
- Internal links use root-relative paths (`/blog/...`, `/sign-up`).
- Image paths use `../../../assets/...` (English depth).

## 4. After publishing
Run:
```bash
node scripts/extract-translations.mjs src/content/blog/live/`<slug>`.md \
  multilang-translation.csv fr de es it pt
```
to append this article's translatable chunks to the master CSV. Upload the
CSV to AI Glot and ask it to fill every language column, then run:
```bash
node scripts/assemble-blog-translations.mjs multilang-translation_translated.csv
```
to generate the localized markdown files.

## 5. Anti-patterns
- Do NOT use em-dashes; use commas or colons.
- Do NOT bold entire paragraphs. Bold key phrases only.
- Do NOT skip an FAQ section; FAQs are among the highest-value SEO blocks.
- Do NOT inline raw HTML inside markdown unless absolutely necessary;
  it complicates chunk-based reassembly.
Na próxima vez que você (ou qualquer pessoa da sua equipe) escrever um novo artigo, o assistente lerá este arquivo primeiro e produzirá um post que se encaixe no pipeline sem a necessidade de limpeza manual.
Bônus 2: Adicionando um novo idioma a todo o seu blog em um único lote
Esta é a parte que mais surpreende as pessoas. Uma vez que o pipeline existe, adicionar um novo idioma é uma operação de um único CSV para todo o arquivo do seu blog.
Digamos que você tenha 80 artigos traduzidos para francês, alemão, espanhol, italiano e português, e decida adicionar o holandês.
O fluxo de trabalho:
- Execute novamente seu script de extração com
nladicionado à lista de locais. Como o script lê da pasta de origem em inglês, todos os artigos (antigos e novos) são incluídos. - Abra o CSV. A coluna
English stringé idêntica à última vez. As colunasfr, de, es, it, ptainda estão vazias (o script não olha para as traduções existentes, ele apenas constrói a matriz vazia). A colunanlé nova e está vazia. - Remova as colunas que você não precisa retraduzir. Exclua
fr, de, es, it, ptda planilha, mantendopath, English string, nl. - Faça o upload para o AI Glot e peça para traduzir
English stringapenas paranl. - Execute o script de remontagem com o novo CSV. Ele gravará cada artigo em
src/content/blog/nl/live/.
Você passou de “precisamos adicionar holandês” para “holandês publicado” em um único upload. Para 80 artigos. É assim que fica quando o fluxo de trabalho faz o serviço, não a equipe.
O mesmo padrão funciona para alterações pontuais: edite um único parágrafo em inglês, re-exporte apenas os trechos afetados, traduza-os e reconstrua. As atualizações continuam baratas porque o pipeline é estrutural, não baseado em documentos.
Checklist de verificação
Antes de publicar em produção, faça um teste de sanidade em cada local:
npm run build(ouastro build) é concluído sem erros deImageNotFound.- Passe o mouse sobre o seletor de idiomas em um post localizado e confirme se a URL permanece limpa.
- Abra um post em francês e faça uma verificação rápida: título, meta descrição, três primeiros parágrafos e uma resposta de FAQ. Compare com a origem.
- Clique em um link interno dentro do post em francês. Ele deve levar a outra página em francês, não de volta para o inglês.
- Inspecione o
<head>para verificar as anotaçõeshreflangcorretas em todos os locais. - Execute uma auditoria do Lighthouse em uma URL localizada; a pontuação de SEO deve ser a mesma do equivalente em inglês.
Se algum desses falhar, os culpados mais comuns são: profundidade de caminho de imagem incorreta, um link interno que escapou do regex ou um trecho que se perdeu entre a extração e a remontagem. Os avisos de “could not find chunk” do script de remontagem indicam exatamente onde procurar.
A conclusão
Tratar um site Astro multilíngue como um pipeline de conteúdo, em vez de um projeto de tradução único, é o que o torna sustentável. Acerte o pipeline (roteamento de locale, extração de CSV em blocos, tradução com AI Glot, remontagem determinística) e traduzir um novo artigo, corrigir um parágrafo ou adicionar um novo idioma se torna uma operação rotineira, em vez de uma iniciativa trimestral.
As peças que fazem isso funcionar:
- i18n nativo do Astro para páginas estáticas limpas por local.
- Um pequeno script de extração que transforma markdown em um CSV traduzível.
- Tradução de CSV do AI Glot, instruído em uma frase a preencher cada coluna de idioma em uma única passagem, com controle de glossário e instruções.
- Um script de remontagem que lida com a profundidade das imagens e a localização de links internos.
- Um arquivo de habilidade para que cada novo artigo se encaixe no pipeline por padrão.
Pronto para expandir globalmente? Cadastre-se no AI Glot, envie seu primeiro CSV de extração e veja seu blog entrar no ar em seis idiomas até o final da tarde.