La traduction en masse ne fonctionne que si la structure du fichier survit à la traduction.
C’est l’aspect que la plupart des gens sous-estiment. Traduire un paragraphe avec l’IA est facile. Traduire 5 000 descriptions de produits, 800 chaînes d’application ou un export complet du CMS Webflow est un problème différent.
À cette échelle, le risque n’est pas seulement une mauvaise phrase. Le vrai risque est un fichier corrompu: lignes manquantes, colonnes décalées, URL traduites, SKU modifiés, en-têtes dupliqués ou termes de marque qui mutent à mi-parcours du jeu de données.
C’est pourquoi le meilleur flux de travail pour la traduction en masse est prioritaire sur le CSV, conscient des colonnes et contrôlé par un glossaire.
Pourquoi les outils de chat peinent avec les fichiers volumineux
Copier-coller un grand tableur dans ChatGPT ou un autre outil d’IA généraliste semble tentant, car le premier test semble généralement concluant.
Puis le fichier s’alourdit.
Le modèle commence à résumer les lignes au lieu de les traduire. Il peut traduire vos en-têtes de colonnes de manière incohérente. Il peut traiter les virgules, les guillemets ou les sauts de ligne comme du texte normal au lieu de la syntaxe du fichier. Il peut également traduire “utilement” des données qui ne devraient jamais changer, comme les URL d’images, les codes SKU, les handles, les ID ou les slugs de catégorie.
Pour un paragraphe marketing, c’est agaçant. Pour un import CSV, cela peut bloquer le système suivant dans la chaîne.
La traduction en masse nécessite un flux de travail qui traite votre fichier comme des données structurées, et non comme un bloc de texte.
Étape 1: Exporter le fichier en CSV
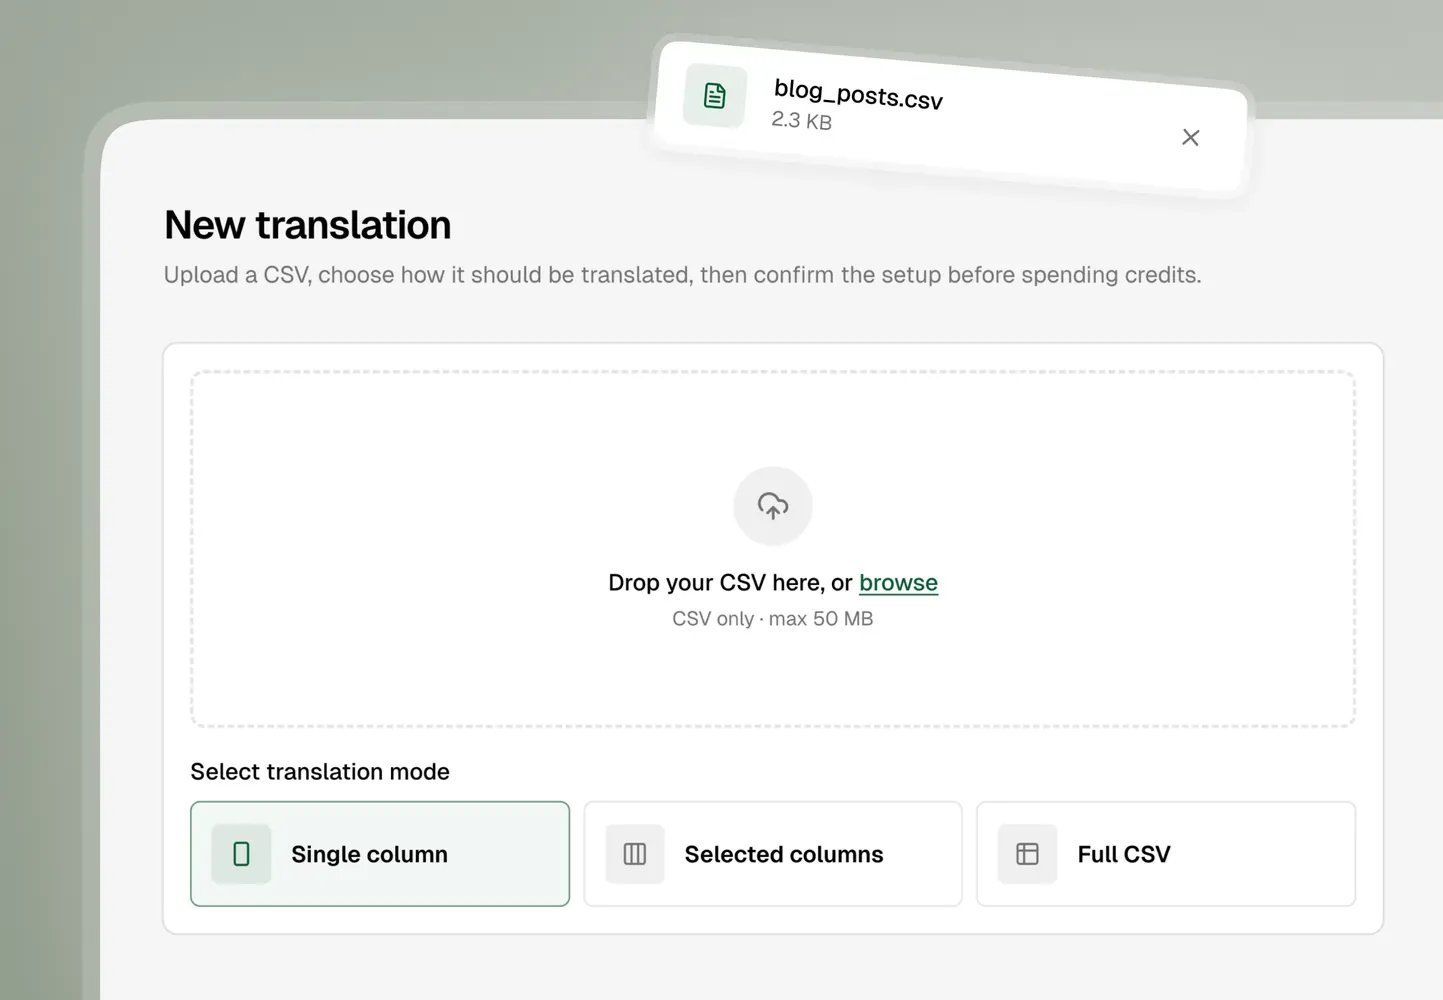
Commencez par placer votre contenu dans un fichier CSV propre.
Le CSV est utile car il maintient la structure importante visible : lignes, colonnes, en-têtes et cellules individuelles. Que votre source soit Excel, Google Sheets, Shopify, WooCommerce, Webflow, Airtable, un export SQL ou un outil interne personnalisé, le CSV vous offre un format de transfert pratique.
Avant de télécharger, effectuez un nettoyage rapide:
- Conservez une ligne d’en-tête claire.
- Supprimez les colonnes vides qui n’ont pas besoin de passer par le flux de travail.
- Gardez les ID, URL, SKU, handles et prix dans leurs propres colonnes.
- Évitez de fusionner différents types de contenu dans un seul champ désordonné.
Plus votre CSV est propre, meilleur sera le résultat de votre traduction.
Étape 2: Décider de ce qui doit être traduit
La plupart des fichiers contiennent deux types de colonnes.
Les colonnes de contenu sont des champs tels que les noms de produits, les descriptions, les titres SEO, les méta-descriptions, les textes du centre d’aide, le corps des e-mails ou les libellés de l’interface utilisateur.
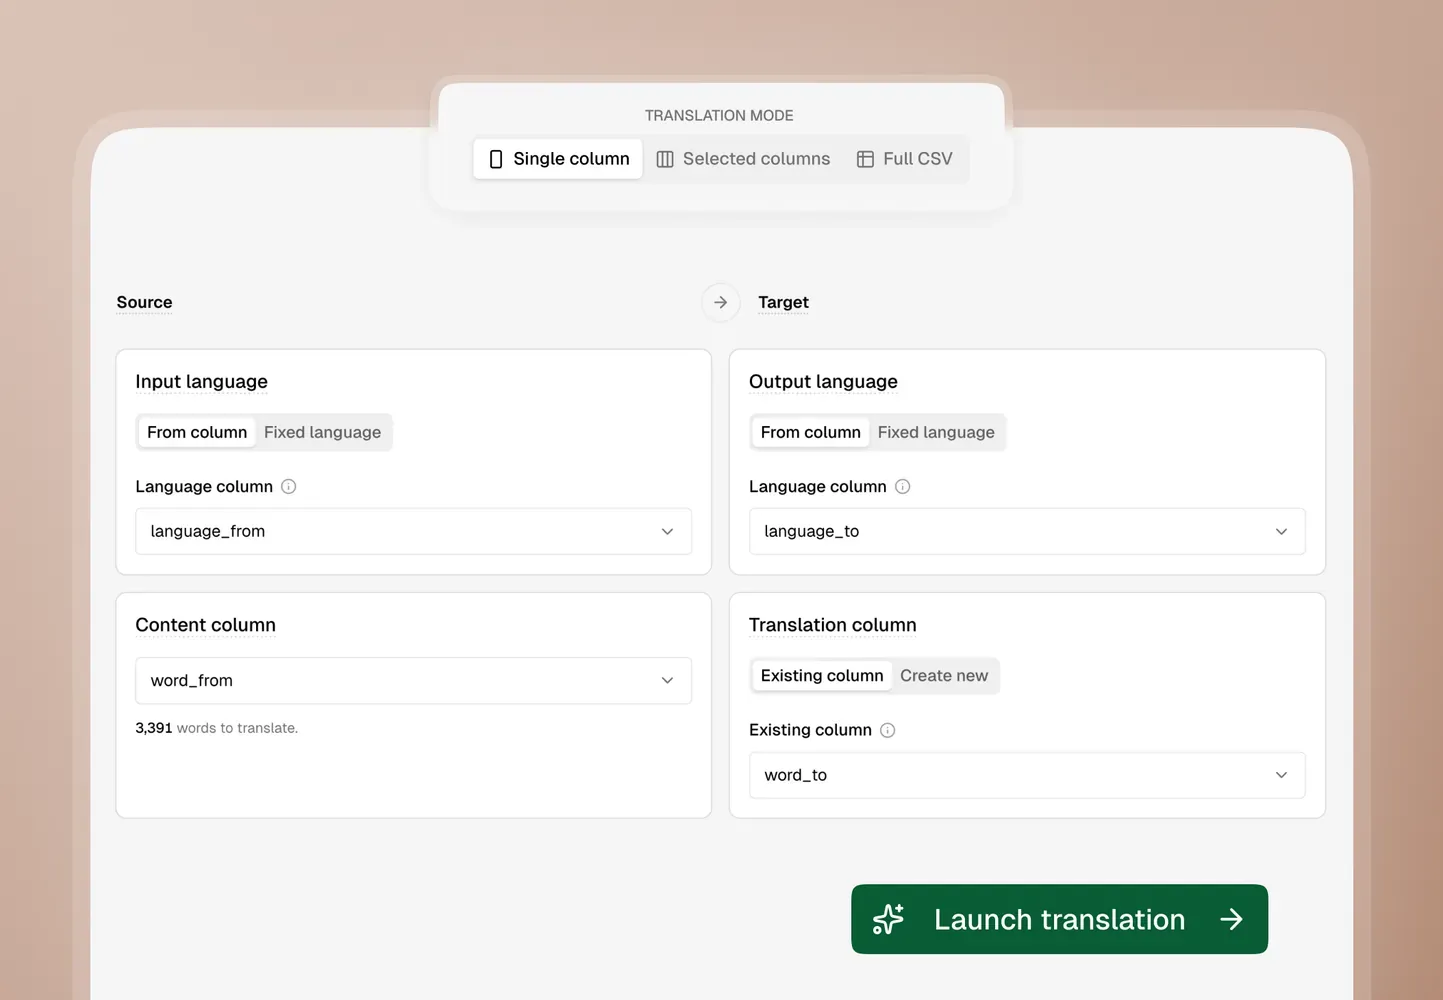
Les colonnes structurelles sont des champs tels que les ID de produits, les slugs, les SKU, les URL d’images, les prix, les dates, les stocks, les catégories ou les handles d’importation.
Seules les colonnes de contenu doivent être traduites.
C’est ici que AI Glot se distingue d’un chat IA générique. Vous téléchargez un CSV et lui indiquez, en une seule phrase, exactement quels champs traduire et quels champs préserver.
Par exemple :
product_id: Ignorertitle_en: Traduiredescription_en: Traduireimage_url: Ignorerprice: Ignorer
Cette unique instruction est ce qui protège votre fichier d’importation.
Une fois que le plan proposé par AI Glot vous semble correct, effectuez une vérification rapide avant de lancer le traitement par lot. C’est là que vous corrigez les erreurs bêtes qui coûtent le plus de temps par la suite.
Étape 3 : Utiliser un glossaire avant le premier lot
La traduction en masse accentue les incohérences.
Si une IA traduit le nom d’une fonctionnalité d’une manière à la ligne 12 et d’une autre à la ligne 1 200, les lecteurs le remarqueront. Dans l’ecommerce, le même problème peut survenir avec les matériaux des produits, les noms de collections, les conditions de garantie, le lexique des tailles ou les technologies de marque.
Un glossaire de traduction fournit un livre de règles à l’IA.
Utilisez-le pour :
- Les noms de marque qui doivent rester inchangés.
- Les gammes de produits et les noms de fonctionnalités propriétaires.
- Les termes techniques du secteur nécessitant des traductions approuvées.
- Les termes d’interface utilisateur comme “tableau de bord”, “paiement”, “espace de travail” ou “avis”.
- Les mots qui ne doivent jamais être traduits.
Cela transforme l’IA, qui passe d’un traducteur intuitif à un assistant de localisation contrôlé.
Étape 4 : Traduire par lots, puis réviser le résultat
Une fois vos colonnes et votre glossaire prêts, lancez la traduction.
Une plateforme structurée traite le fichier cellule par cellule, ne touche pas aux colonnes ignorées et renvoie un CSV prêt à être réimporté dans votre système source.
Ne faites pas l’impasse sur la révision. L’objectif de la traduction par IA n’est pas de supprimer le jugement humain. L’objectif est de supprimer le travail répétitif tout en concentrant la révision sur les champs essentiels.
Vérifiez quelques lignes à risque :
- Les descriptions longues avec de la ponctuation.
- Les lignes contenant du HTML.
- Les lignes contenant des termes de marque.
- Les lignes avec des cellules vides.
- Les lignes avec des guillemets, des virgules ou des sauts de ligne.
Si elles sont correctes, vous pourrez valider le lot avec beaucoup plus de confiance.
Un flux de traduction en masse qui passe à l’échelle
Le flux de travail fiable est simple :
- Exporter vers CSV.
- Sélectionner uniquement les colonnes à traduire.
- Protéger les champs structurels.
- Appliquer un glossaire.
- Traduire, réviser et réimporter.
C’est là toute la différence entre “l’IA a traduit du texte” et un fichier de localisation que vous pouvez réellement déployer.
Prêt à traduire un véritable fichier volumineux ? Essayez AI Glot et traitez votre premier CSV avec le contrôle des colonnes, la prise en charge des glossaires et un flux de révision conçu pour les données structurées.