Kort samengevat: een meertalige Astro-site is in de eerste plaats een structureel probleem, en pas daarna een vertaalprobleem. Maak per taal nette contentmappen, haal alle vertaalbare onderdelen op en zet ze in één CSV. Vraag AI Glot in één zin om alle taalkolommen in te vullen met AI Glot’s CSV translation en zet de bestanden daarna programmatisch weer in elkaar. Zodra de workflow staat, voeg je een nieuwe taal toe met één CSV.
Dit is precies de workflow waarmee we ai-glot.com in zes talen onderhouden (Engels, Frans, Duits, Spaans, Italiaans en Portugees), zonder ook maar één blogartikel met de hand te herschrijven. We nemen je stap voor stap mee en delen de prompts waarmee we elke stap opzetten met een AI-codeerassistent zoals Claude Code of Cursor.
Het doel
Aan het einde van deze gids heb je:
- Een overzichtelijke i18n-routeringsstructuur in je Astro-project, met een aparte map voor elke taal.
- Een herbruikbaar script dat alle vertaalbare teksten uit een markdownbestand (of een CMS-export) haalt en in één CSV zet.
- Een vertaalde CSV die in één keer met AI Glot is ingevuld voor alle taalkolommen.
- Een tweede script dat de vertaalde markdownbestanden weer samenstelt en afbeeldingspaden en interne links aanpast aan de gelokaliseerde submappen.
- Een skillbestand voor je AI-assistent, zodat elk nieuw artikel standaard klaar is om vertaald te worden.
Gebruik je al Weglot, Crowdin of een headless CMS dat CSV-bestanden exporteert? Dan kun je het extractiescript voor markdown overslaan en die exports rechtstreeks in AI Glot laden. De vertaal- en samenstellogica werkt hetzelfde voor elk project rond CMS-content vertalen.
Vereisten
Een korte checklist voordat je begint.
- Een Astro-project (v4 of v5) dat lokaal draait, met contentcollecties voor je blog.
- Node 20 of hoger, zodat de moderne CSV- en
fs/promises-API’s probleemloos werken. - Een AI Glot-account (met het gratis abonnement kun je prima met je eerste batch aan de slag).
- Een AI-assistent in je editor om de basiscode te genereren (Claude Code, Cursor, Copilot, Codeium, kies maar).
Waarom Astro ideaal is voor meertalige sites op schaal
Astro genereert standaard statische HTML. Dat betekent dat elke gelokaliseerde pagina gewoon een bestand op schijf is. Er is geen vertaalmechanisme dat tijdens runtime actief is, geen databasezoekopdracht voor een taalkeuzemenu en geen JavaScript-bundel die je per taal moet downloaden. Google indexeert elke taalversie als een afzonderlijke URL met eigen metatags. De build-output is in feite een vertaalde spiegel van je Engelstalige site.
Dat is precies wat je wilt voor SEO. Meertalige SEO werkt het best als elke taal een eigen crawlbare, statisch gegenereerde pagina heeft, met de juiste hreflang-annotaties en een overzichtelijke URL-structuur. Astro biedt dit standaard.
De keerzijde: je moet zelf zorgen dat de contentbestanden in alle talen synchroon blijven. Precies dat probleem lost de CSV-workflow hieronder op.
Deel 1: De i18n-routeringsstructuur instellen
Astro 4 introduceerde eersteklas i18n-configuratie. De overzichtelijkste aanpak is om je talen op te geven, geen prefix te gebruiken voor de standaardtaal (Engelse pagina’s staan dan op /blog/my-post en Franse op /fr/blog/my-post) en je contentcollecties per taal te spiegelen in een map [lang]/.
Dit is een voorbeeld van een mappenstructuur voor een blog in zes talen:
src/
  content/
    blog/
      live/                          # English (default locale)
        my-first-post.md
      fr/live/                       # French
        my-first-post.md
      de/live/                       # German
        my-first-post.md
      es/live/                       # Spanish
        my-first-post.md
      it/live/                       # Italian
        my-first-post.md
      pt/live/                       # Portuguese
        my-first-post.md
  pages/
    blog/[slug].astro                # English routes
    [lang]/blog/[slug].astro         # Localized routes
  i18n/
    ui.ts                            # UI string dictionary per locale
Let op: de gelokaliseerde markdown-bestanden staan één mapniveau dieper dan de Engelse bestanden. Dat verschil is belangrijk: relatieve afbeeldingspaden in gelokaliseerde markdown hebben een extra ../ nodig om bij src/assets/ te komen. Het script voor het samenvoegen in deel 4 regelt dit automatisch.
Wil je deze basisstructuur liever niet zelf schrijven? Geef dan de volgende prompt aan je AI-codeassistent. De prompt is bewust algemeen gehouden, zodat hij voor elk Astro-project werkt. Ook vraagt hij eerst om de juiste verduidelijkingen voordat er code wordt gegenereerd.
You are helping me scaffold internationalization (i18n) in an existing Astro
project. I want to translate my entire site into multiple languages while
keeping clean URLs, proper hreflang annotations, and per-locale static pages.

Goals:
1. Declare locales in astro.config.mjs using the built-in `i18n` option.
   Default locale should NOT be prefixed (e.g. English lives at `/blog/...`,
   French at `/fr/blog/...`).
2. Create a per-locale folder structure for my content collections so each
   blog post (or CMS item) has a 1:1 file per language. The English files
   stay at their current location; localized files live one folder deeper
   (e.g. `src/content/blog/fr/live/`).
3. Add a typed UI string dictionary at `src/i18n/ui.ts` that exports an object
   keyed by locale, plus a `useTranslations(lang)` helper.
4. Update the content collection schema so the same Zod definition applies to
   every language folder.
5. Generate the dynamic route file `src/pages/[lang]/blog/[slug].astro` that
   reads from the localized content collection and falls back to English when
   a localized version is missing.
6. Add a `<LanguageSwitcher />` component that renders an anchor per locale,
   preserving the current pathname.
7. Inject `<link rel="alternate" hreflang="..." />` tags into the layout for
   every locale that has the page available.

Before you generate any code, ask me:
- The list of target locales (BCP 47 codes) and which one is the default.
- The path to my existing content collection(s) and current route files.
- Whether I want a language switcher in the header, footer, or both.
- Whether I store UI strings in JSON, TS, or somewhere else today.

Then make the changes in small, surgical commits. Do not refactor unrelated
code. Show me the diff and explain any decision where there are two valid
patterns (e.g. prefixed vs. non-prefixed default locale).
Deze aanpak is bewust gekozen: eerst verduidelijken, dan bouwen. We probeerden in het begin de aanpak “genereer gewoon alles” en eindigden met drie verschillende componenten voor het taalkeuzemenu en een routeringsschema dat botste met ons schema voor contentcollecties. Als je de assistent vraagt eerst vragen te stellen, bespaar je jezelf later een uur opruimwerk.
Deel 2: Exporteer je content naar een CSV-bestand voor vertaling
Hier lopen de meeste teams vast. De vertaling zelf is het makkelijke deel. Je content van en naar een vertaaltool overbrengen zonder de structuur te beschadigen, is het moeilijke deel.
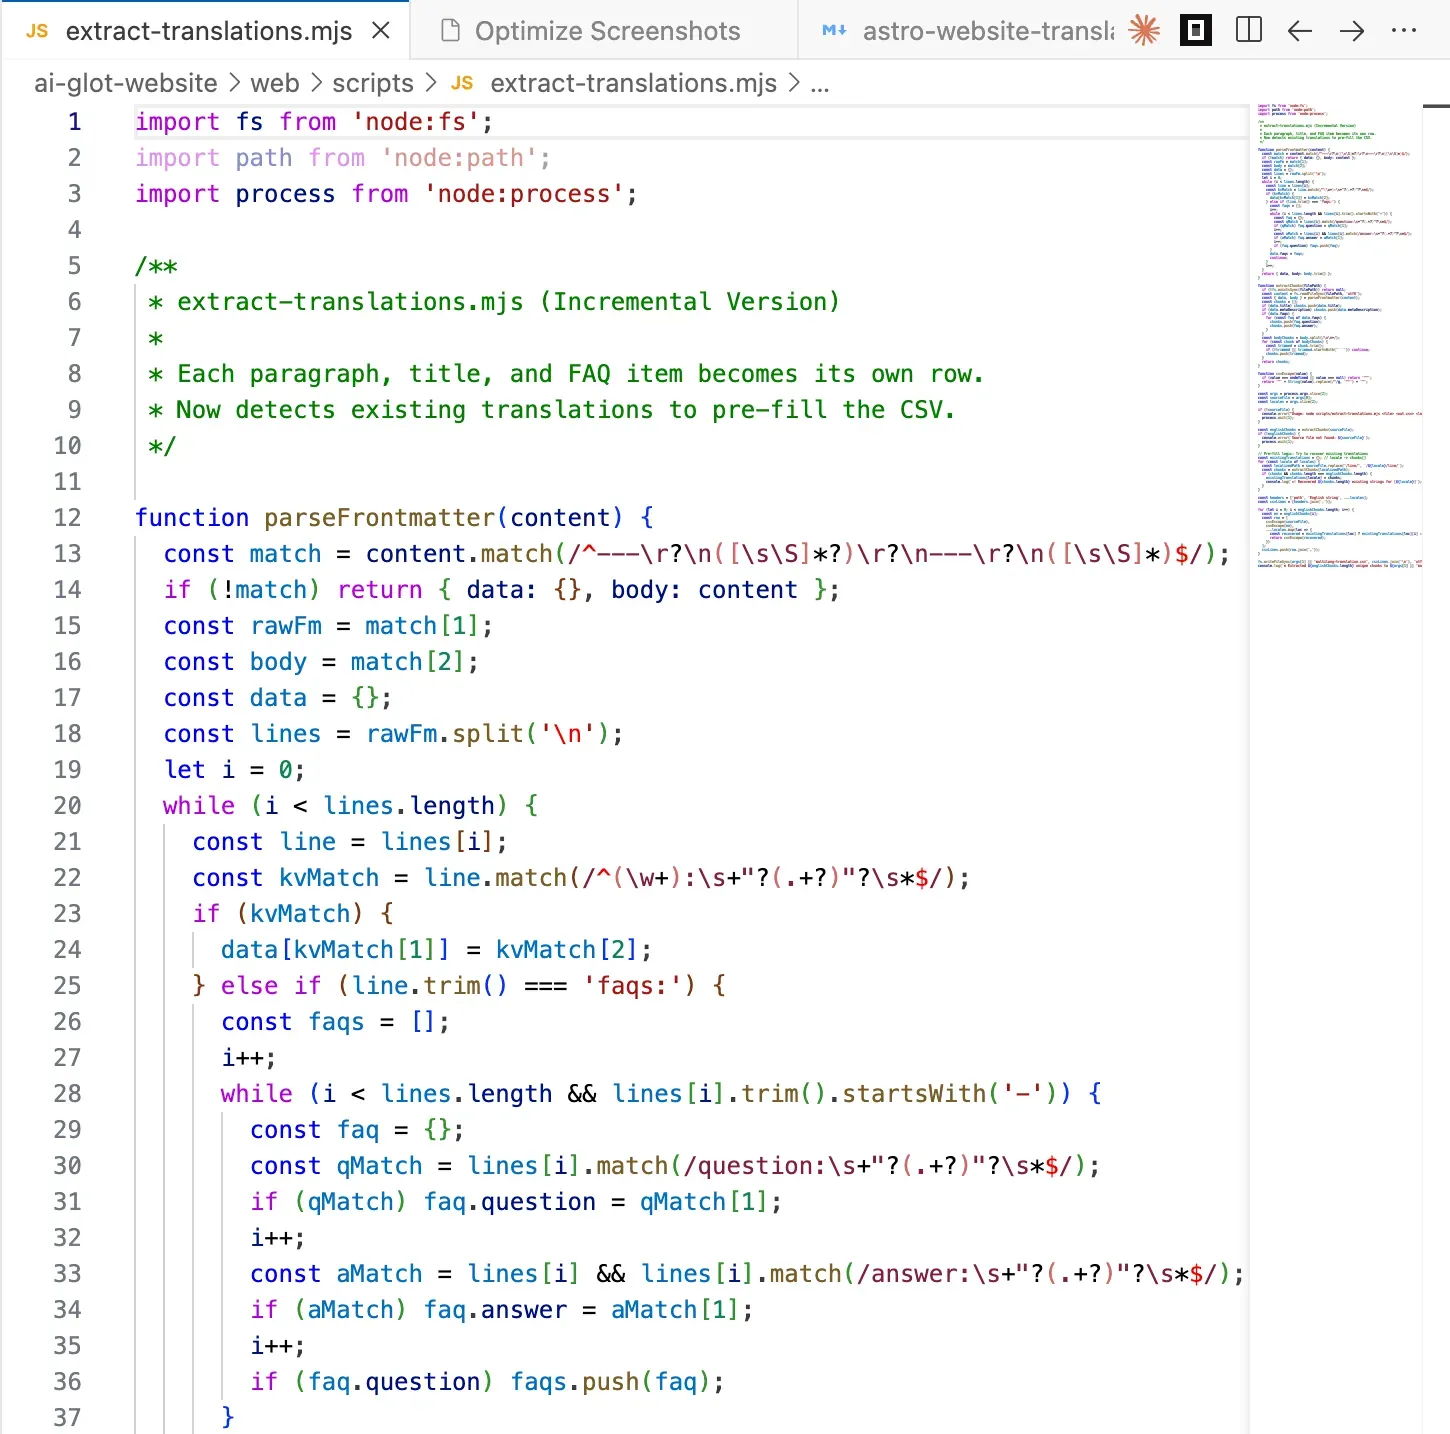
De truc om dit goed te laten werken in AI Glot is extractie in overzichtelijke delen. Verdeel elk markdown-bestand in de kleinste betekenisvolle vertaalbare eenheden (een frontmatter-veld, een FAQ-vraag en -antwoord, één alinea), zet elk onderdeel op een eigen rij in een CSV-bestand en voeg één kolom per doeltaal toe. Dat ziet er zo uit:
| pad | Engelse tekst | fr | de | es | it | pt |
|---|---|---|---|---|---|---|
| live/my-first-post.md | Een Astro-website op schaal naar veel talen vertalen | |||||
| live/my-first-post.md | Een praktische tutorial om een meertalige Astro-site te publiceren. Kopieer en plak de voorbeelden. | |||||
| live/my-first-post.md | Astro genereert standaard statische HTML. Dat betekent dat elke gelokaliseerde pagina gewoon een bestand op schijf is. |
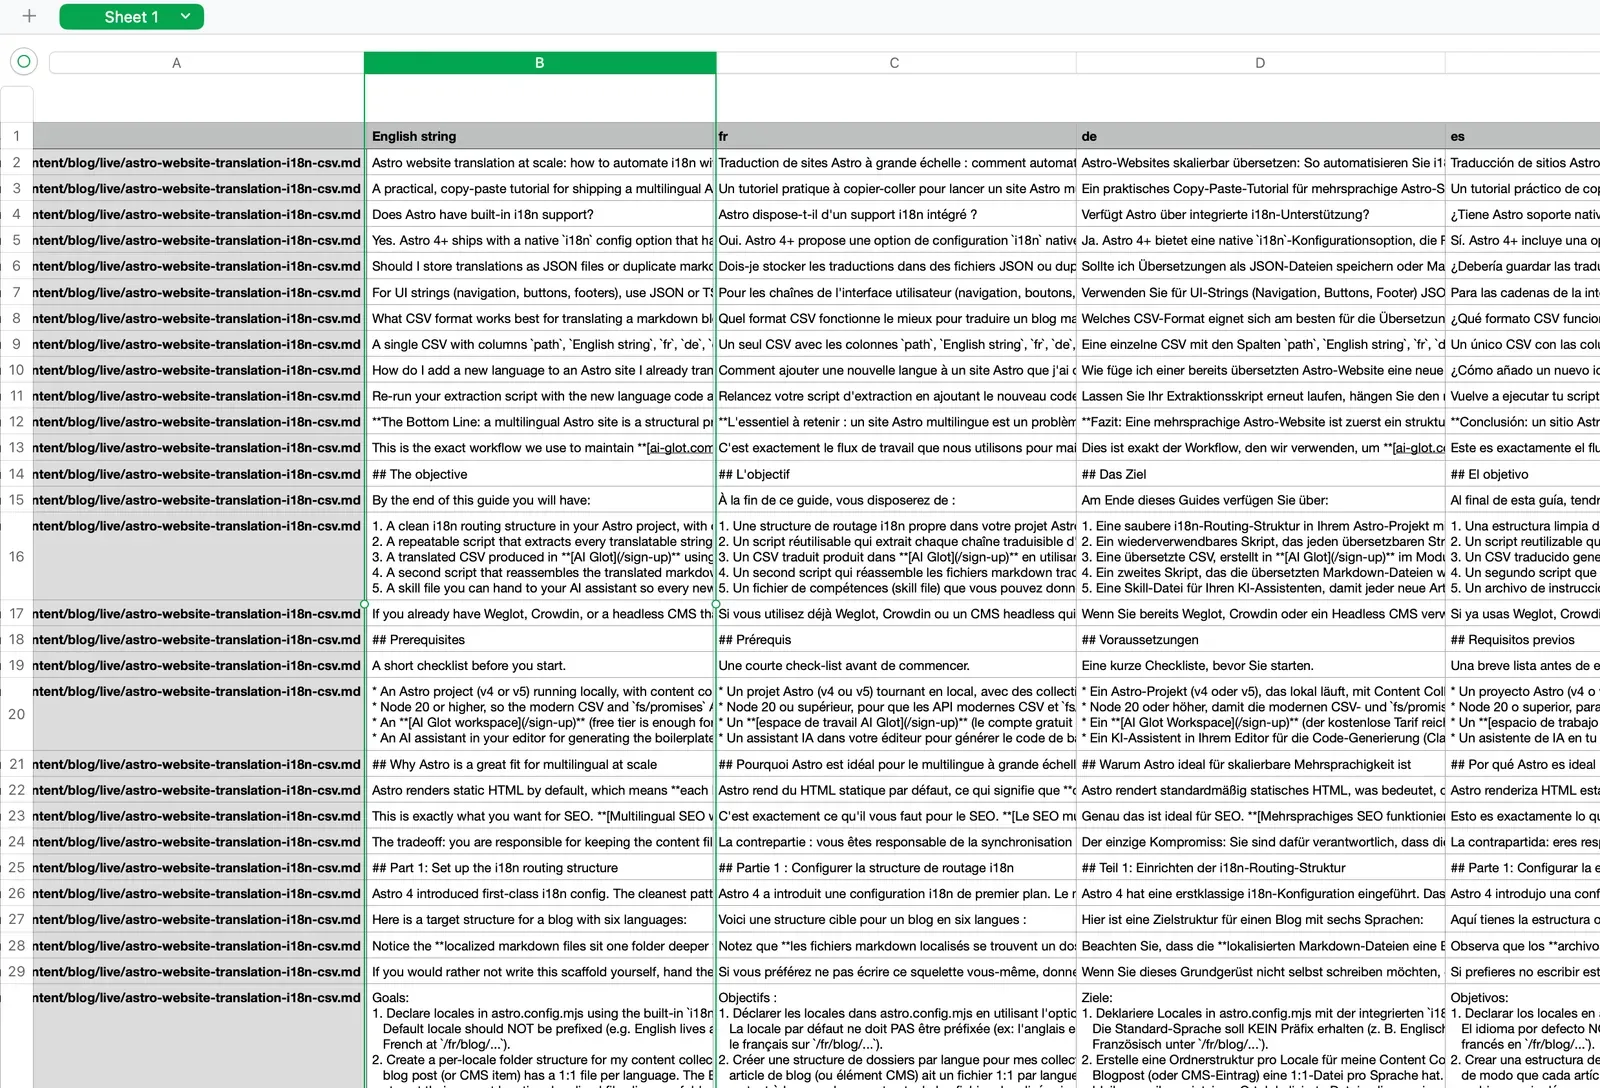
Waarom de content in delen opsplitsen? Omdat AI-vertalingen veel beter werken met samenhangende eenheden ter grootte van een alinea dan met volledige documenten. De regels uit de woordenlijst worden consistent toegepast, het aantal benodigde tokens blijft voorspelbaar en als één onderdeel moet worden aangepast, wijzig je één cel in plaats van een bestand van 2.000 woorden.
Optie A: Je slaat content op als Markdown-bestanden (blogs, documentatie, landingspagina’s)
Gebruik deze prompt om een extractiescript op maat van je repo te genereren. We gebruiken een bijna identieke versie voor de website van AI Glot.
Write a Node.js script at `scripts/extract-translations.mjs` that prepares a
CSV for bulk translation in AI Glot.
Inputs:
- A source directory containing English markdown files
(e.g. `src/content/blog/live/`).
- A list of target locale codes (e.g. `fr de es it pt`).
- An output CSV path (default `multilang-translation.csv`).
For each markdown file:
1. Parse the frontmatter using `gray-matter`.
2. Extract these translatable strings, one per CSV row:
- `title` (frontmatter)
- `metaDescription` (frontmatter)
- For each entry in `faqs`: the `question` and the `answer` as separate rows.
- Each body paragraph, splitting the markdown body on `\n\n` so paragraphs,
bullet lists, blockquotes, and headings each become one row.
3. SKIP these chunks (do not include them in the CSV):
- Pure image lines starting with `
Deel 4: Zet de vertaalde Markdown terug in Astro
Je hebt nu een multilang-translation_translated.csv waarin alle doelkolommen zijn ingevuld. De volgende stap is om elk vertaald tekstfragment terug te zetten in het juiste gelokaliseerde Markdown-bestand, waarbij de oorspronkelijke structuur exact behouden blijft.
Hier bewijst het opdelen in tekstfragmenten opnieuw zijn waarde. Omdat elke rij gekoppeld is aan het oorspronkelijke Engelse tekstfragment, kun je in het originele bronbestand eenvoudig het Engelse tekstfragment vervangen door de vertaling en het resultaat opslaan in de map voor de betreffende taal. Geen AST-parsing, geen omzetting van en naar Markdown en geen risico dat de opmaak verloren gaat.
Bij het terugzetten moeten twee structurele aanpassingen worden doorgevoerd:
- Afbeeldingspaden. Engelstalige bestanden verwijzen met
../../../assets/...naar assets. Gelokaliseerde bestanden staan een map dieper, dus wordt het relatieve pad../../../../assets/.... - Interne links. Een link zoals
/blog/glossary-website-translationsin het Engels moet in het Frans worden/fr/blog/glossary-website-translations(en zo ook voor elke andere taal).
Dit is de prompt die we gebruiken om het script voor het opnieuw samenstellen te genereren. De prompt is algemeen genoeg om te gebruiken in elk Astro-project met de structuur uit deel 1.
Use the unified assembly script at `scripts/assemble-blog-translations.mjs` that rebuilds
localized markdown files from an AI Glot translated CSV.

Inputs (CLI args):
- Path to the translated CSV (e.g. `multilang-translation_translated.csv`)
  with columns `path, English string, fr, de, es, it, pt`.
- The source directory containing the original English markdown files
  (default `src/content/blog/live/`).
- The destination directory pattern for localized files
  (default `src/content/blog/{lang}/live/`).
- The site origin used for internal links (default `https://ai-glot.com`).

For each unique `path` value in the CSV:
1. Read the original English file from `<sourceDir>/<path>`.
2. For each target locale column (everything after `English string`):
   a. Start from the English file's full text.
   b. For every row that matches this `path`, find the `English string`
      verbatim in the file and replace it with the value in the target
      locale column. Use literal string replace, not regex. Throw if the
      English chunk is not found (it means the source drifted from the CSV;
      this should fail loudly rather than silently skip).
   c. After all replacements, run two structural fixes on the resulting text:
      - Image paths: replace every occurrence of `../../../assets/` with
        `../../../../assets/` (one extra `../` because localized files live
        one folder deeper).
      - Internal links: replace every absolute internal URL on this site
        (e.g. `https://ai-glot.com/blog/...`) and every root-relative path
        (e.g. `/blog/...`, `/sign-up`) with the locale-prefixed equivalent
        (`/fr/blog/...`, `/fr/sign-up`). Skip anchors (`#...`), external URLs,
        and `mailto:` / `tel:` links.
   d. Write the file to `<destDir resolved with this lang>/<path>`. Create
      directories as needed.
3. After processing all paths, print a summary: files written per locale,
   total replacements, any chunks that could not be found.

Robustness:
- Use `papaparse` to read the CSV. Trim BOM if present.
- Preserve the exact frontmatter formatting (delimiters, key order, quoting).
  The simplest way is to do replacements on the raw file string, not on a
  parsed AST.
- Be idempotent: running the script twice on the same inputs produces the
  same outputs.

Make it a single self-contained file. Usage:
`node scripts/assemble-blog-translations.mjs translated.csv`
Voer het script uit en je ziet een reeks nieuwe bestanden verschijnen in src/content/blog/fr/live/, src/content/blog/de/live/ enzovoort. Controleer er één steekproefsgewijs, voer astro dev uit en je gelokaliseerde routes zouden meteen moeten worden weergegeven.
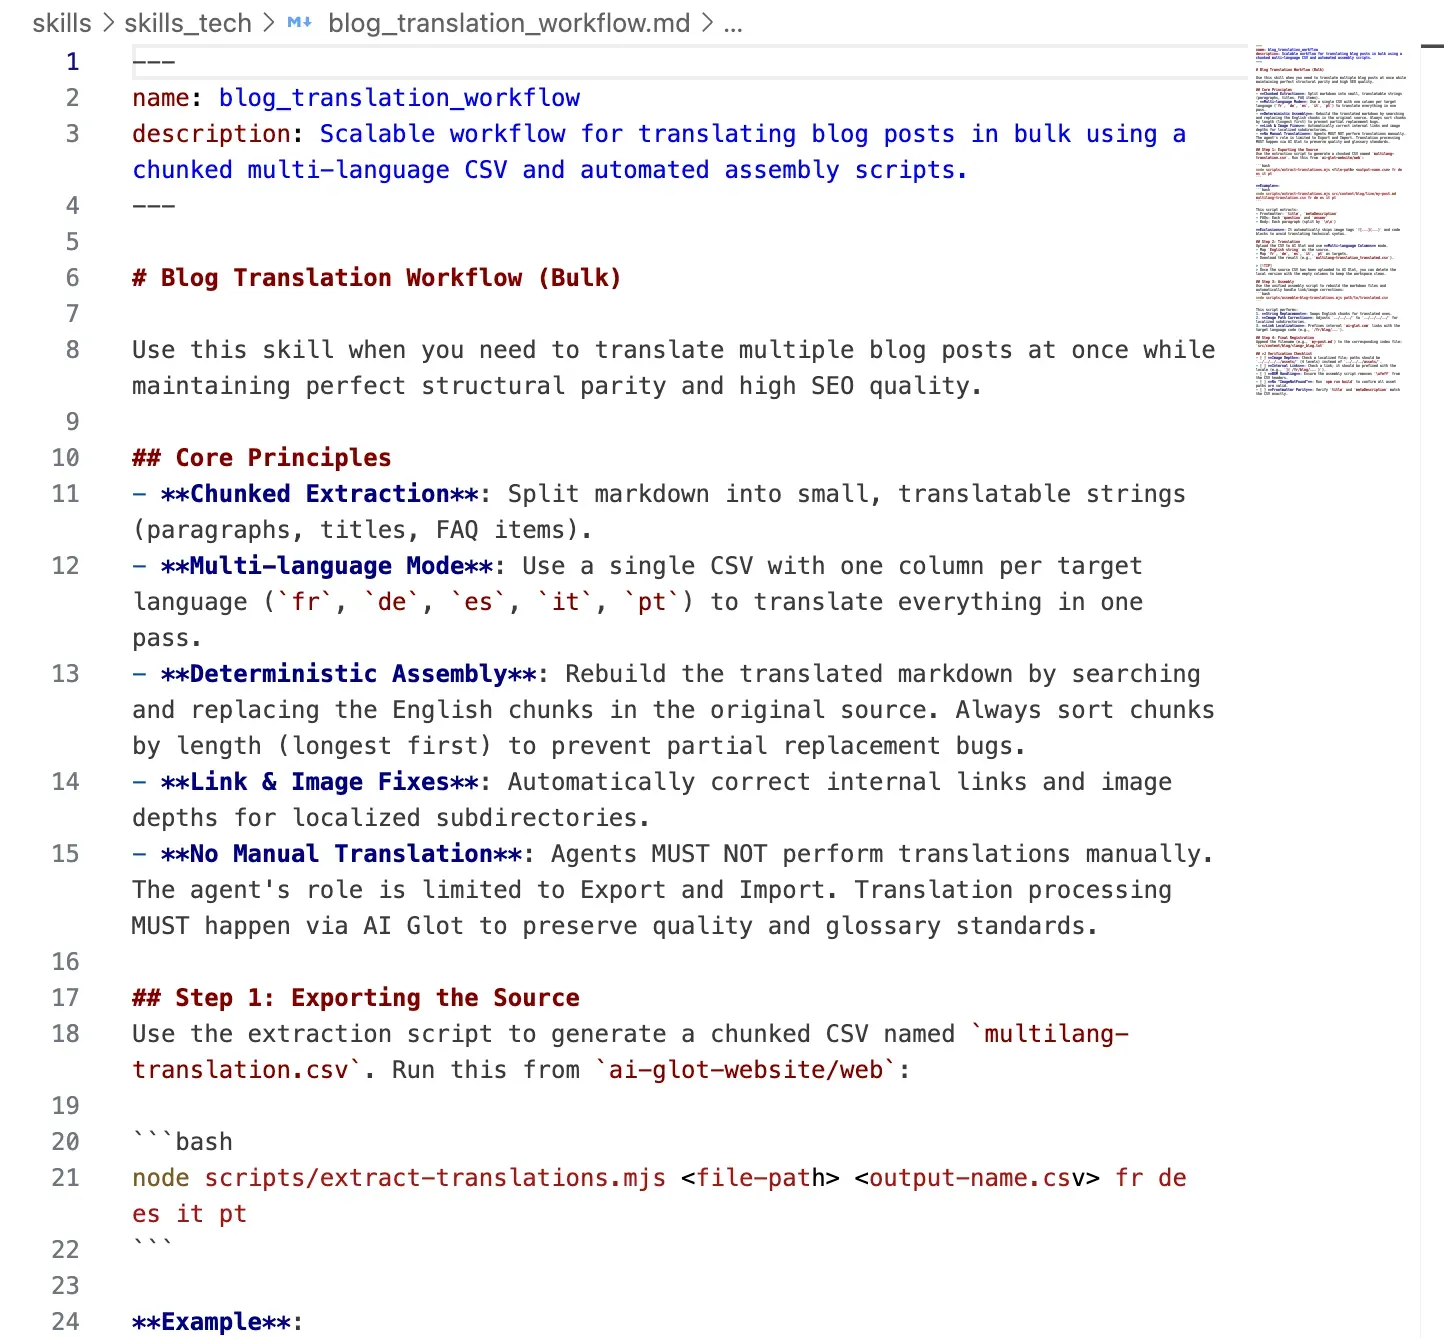
Bonus 1: Een vaardigheidsbestand zodat elk nieuw artikel standaard klaar is om te vertalen
Zodra de pipeline werkt, wil je dat elk toekomstig artikel er op dezelfde manier doorheen gaat. De truc: leg de conventies vast in een vaardigheidsbestand dat je AI-assistent leest voordat die een nieuw artikel schrijft.
Gebruik je Claude Code, Cursor of een andere AI-editor die projectinstructies laadt? Zet dit bestand dan in je repo als skills/blog_translation_workflow.md. Bij AI Glot gebruiken we precies deze aanpak.
---
name: blog_translation_workflow
description: How to ship a new blog post so it can be translated in bulk later.
---

# Blog translation workflow

When writing a new blog post or CMS item, follow these conventions so it
flows cleanly through the multilingual extraction pipeline.

## 1. File location and naming
- Drafts live under `src/content/blog/draft/`.
- Slug = filename = the same string used in `slug:` frontmatter.
- Move to `src/content/blog/live/` only after review.

## 2. Frontmatter contract
Every post MUST have:
- `title`: sentence case, no trailing period.
- `metaDescription`: 140 to 160 characters, full sentence.
- `coverImage`: relative path from this file's location.
- `publishedDate`: ISO date.
- `slug`: matches the filename.
- `faqs`: array of `{ question, answer }`. Minimum 3 items.

## 3. Body structure that translates well
- Use sentence-case headings (no Title Case).
- Keep paragraphs to 1 to 4 sentences. Each paragraph becomes one CSV row,
  so shorter paragraphs translate more reliably.
- Never put two images back to back; always separate them with at least one
  paragraph of explanatory text.
- Internal links use root-relative paths (`/blog/...`, `/sign-up`).
- Image paths use `../../../assets/...` (English depth).

## 4. After publishing
Run:
```bash
node scripts/extract-translations.mjs src/content/blog/live/`<slug>`.md \
  multilang-translation.csv fr de es it pt
```
to append this article's translatable chunks to the master CSV. Upload the
CSV to AI Glot and ask it to fill every language column, then run:
```bash
node scripts/assemble-blog-translations.mjs multilang-translation_translated.csv
```
to generate the localized markdown files.

## 5. Anti-patterns
- Do NOT use em-dashes; use commas or colons.
- Do NOT bold entire paragraphs. Bold key phrases only.
- Do NOT skip an FAQ section; FAQs are among the highest-value SEO blocks.
- Do NOT inline raw HTML inside markdown unless absolutely necessary;
  it complicates chunk-based reassembly.
De volgende keer dat jij (of iemand in je team) een nieuw artikel schrijft, leest de assistent eerst dit bestand en maakt die een artikel dat in de pipeline past, zonder dat je het handmatig hoeft op te schonen.
Bonus 2: In één keer een nieuwe taal toevoegen aan je hele blog
Dit verbaast mensen vaak het meest. Zodra de pipeline staat, voeg je met één CSV-bewerking een nieuwe taal toe aan je volledige blogarchief.
Stel, je hebt 80 artikelen die zijn vertaald naar het Frans, Duits, Spaans, Italiaans en Portugees, en je besluit Nederlands toe te voegen.
Zo werkt het:
- Voer je extractiescript opnieuw uit en voeg
nltoe aan de lijst met talen. Omdat het script de Engelse bronmap uitleest, neemt het alle artikelen mee, zowel oude als nieuwe. - Open de CSV. De kolom
English stringis hetzelfde als de vorige keer. De kolommenfr, de, es, it, ptzijn nog leeg (het script kijkt niet naar bestaande vertalingen, maar maakt alleen de lege matrix aan). De kolomnlis nieuw en leeg. - Verwijder de kolommen die je niet opnieuw hoeft te vertalen. Verwijder
fr, de, es, it, ptuit het spreadsheet en behoudpath, English string, nl. - Upload het bestand naar AI Glot en vraag AI Glot om alleen
English stringnaarnlte vertalen. - Voer het script voor het opnieuw samenstellen uit met de nieuwe CSV. Het schrijft elk artikel naar
src/content/blog/nl/live/.
Van „we moeten Nederlands toevoegen” naar „Nederlands staat live” in één upload. Voor 80 artikelen. Zo ziet het eruit wanneer de workflow het werk doet, niet je team.
Dezelfde aanpak werkt voor eenmalige wijzigingen: pas één Engelse alinea aan, exporteer alleen de betrokken tekstfragmenten opnieuw, vertaal ze en stel de content opnieuw samen. Updates blijven betaalbaar omdat de pipeline structureel is opgezet en niet op documenten is gebaseerd.
Controlelijst voor verificatie
Controleer vóór je naar productie gaat alle talen:
npm run build(ofastro build) slaagt zonder fouten van het typeImageNotFound.- Beweeg de muis over de taalkiezer bij een gelokaliseerd artikel en controleer of de URL netjes blijft.
- Open een Frans artikel en controleer steekproefsgewijs de titel, metabeschrijving, de eerste drie alinea’s en een FAQ-antwoord. Vergelijk ze met de brontekst.
- Klik op een interne link in het Franse artikel. Die moet naar een andere Franse pagina leiden, niet terug naar het Engels.
- Controleer in de
<head>of dehreflang-annotaties voor alle talen kloppen. - Voer een Lighthouse-audit uit op een gelokaliseerde URL. De SEO-score moet gelijk zijn aan die van de Engelse versie.
Als een van deze controles mislukt, zijn de meest voorkomende oorzaken: een onjuiste diepte van het afbeeldingspad, een interne link die buiten de regex viel of een tekstfragment dat tussen het extraheren en opnieuw samenstellen is gewijzigd. De waarschuwingen „could not find chunk” van het script voor het opnieuw samenstellen wijzen precies aan waar je moet zoeken.
De conclusie
Een meertalige Astro-site is pas goed te onderhouden als je die ziet als een contentpipeline en niet als een eenmalig vertaalproject. Richt de pipeline goed in (lokale routering, CSV-extractie in delen, vertaling met AI Glot en deterministische reassemblage) en een nieuw artikel vertalen, een alinea aanpassen of een nieuwe taal toevoegen wordt routine in plaats van een kwartaalproject.
De onderdelen die dit mogelijk maken:
- De ingebouwde i18n-functionaliteit van Astro voor overzichtelijke statische pagina’s per taal.
- Een klein extractiescript dat Markdown omzet in een vertaalbare CSV.
- CSV-vertaling met AI Glot: geef in één zin de opdracht om in één keer alle taalkolommen in te vullen, met controle over de woordenlijst en instructies.
- Een reassemblagescript dat rekening houdt met de diepte van afbeeldingen en interne links lokaliseert.
- Een skillbestand, zodat elk nieuw artikel standaard in de pipeline past.
Klaar om meertalig te publiceren? Meld je aan bij AI Glot, upload je eerste extractie-CSV en zie hoe je blog nog dezelfde middag in zes talen live gaat.